Podręcznik uczestnika z objaśnieniami, przykładami i ćwiczeniami do samodzielnej nauki
4. Fundamenty Matplotlib
Matplotlib rozdziela figurę, obszar wykresu i osie liczbowe. Figure jest całym obrazem, Axes — obszarem, w którym rysujesz dane, a Axis odpowiada za skalę i podziałkę jednej osi. Nazwa Axes bywa myląca: jeden obiekt ax może zawierać zarówno oś poziomą, jak i pionową.
Przygotowanie notebooka
Utwórz notebook w katalogu notebooks i sprawdź katalog roboczy. Poniższy kod celowo zatrzyma się, jeżeli uruchomisz go z innego miejsca. Wówczas popraw katalog roboczy albo jawnie ustaw PROJECT_DIR na katalog swojego projektu. Nie omijaj błędu przez losowe dopisywanie kolejnych znaków ../.
from pathlib import Path
from hashlib import sha256
import numpy as np
import pandas as pd
import matplotlib
import matplotlib.pyplot as plt
import matplotlib.dates as mdates

print(Path.cwd())
print(pd.__version__, matplotlib.__version__)
assert Path.cwd().name == "notebooks"
PROJECT_DIR = Path.cwd().parent
TABLES = PROJECT_DIR / "outputs" / "tables"
FIGURES = PROJECT_DIR / "outputs" / "figures"
TABLES.mkdir(parents=True, exist_ok=True)
FIGURES.mkdir(parents=True, exist_ok=True)
plik = PROJECT_DIR / "data" / "processed" / "pomiary_clean.csv"
assert plik.is_file()
hash_wejscia = sha256(plik.read_bytes()).hexdigest()

plt.rcParams.update({
    "font.family": "DejaVu Sans", "font.size": 12,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.titleweight": "bold", "figure.facecolor": "white"
})

def zapisz(fig, nazwa):
    sciezka = FIGURES / nazwa
    fig.savefig(sciezka, dpi=150, bbox_inches="tight",
                facecolor="white")
    plt.show()
    plt.close(fig)
    return sciezka
Zapisane wersje bibliotek pomogą odtworzyć pracę. Przykłady korzystają z Pandas oraz Matplotlib; parametr tick_labels w rozdziale 4 wymaga Matplotlib 3.9 lub nowszego. Samodzielna lektura książki nie wymaga instalacji. Do pracy offline przygotuj środowisko i pliki przed odłączeniem internetu.
Odczyt danych bez zmiany decyzji z M2
CSV przechowuje tekst, nie pełny schemat typów Pandas. Dlatego przy odczycie ponownie określamy typy i daty. Jest to odtworzenie reprezentacji danych, a nie ponowne rozstrzyganie braków, duplikatów czy nietypowych pomiarów.
typy = {
    "rok_miesiac": "string", "urzadzenie": "string",
    "typ_urzadzenia": "string", "lokalizacja": "string",
    "moc_nominalna_kw": "float64",
    "wiek_urzadzenia_dni": "Int64",
    "temperatura": "float64", "drgania": "float64",
    "energia": "float64", "produkcja": "Int64",
    "tryb": "category", "status": "category"
}
df = pd.read_csv(
    plik, dtype=typy, parse_dates=["czas", "data_instalacji"],
    encoding="utf-8"
)
assert df.shape == (720, 14)
assert df[["czas", "urzadzenie"]].notna().all().all()
assert not df.duplicated(["czas", "urzadzenie"]).any()
assert df["urzadzenie"].value_counts().eq(90).all()
assert df["urzadzenie"].nunique() == 8
assert df["czas"].dt.normalize().nunique() == 45
assert df["energia"].isna().sum() == 2
assert df["produkcja"].isna().sum() == 1
assert df[["temperatura", "drgania"]].notna().all().all()
display(df.head(3))
Oczekiwane liczby dotyczą zbioru kursowego. W innym projekcie ustalasz je z dokumentacji źródła. Asercje nie zastępują przeczytania słownika ani sprawdzenia zakresu czasu: potwierdzają wybrane warunki, nie całą jakość danych.
Jedna figura jedno świadome zadanie
Polecenie fig, ax = plt.subplots() tworzy figurę i obszar wykresu. Dalej korzystasz z metod ax, takich jak barh(), set_xlabel() czy set_title(). Taki zapis jasno wskazuje, który obszar zmieniasz, szczególnie gdy jedna figura zawiera dwa panele. Nie miesza ustawień przypadkowo aktywnych wykresów.
Parametr figsize podaje wymiary w calach, a dpi liczbę pikseli na cal. Figura 10 × 5 cali przy 150 dpi ma nominalnie 1500 × 750 pikseli. Przy bbox_inches="tight" wynikowy rozmiar może być inny, ponieważ zapis przycina obszar do zawartości. Nie obiecuj stałego wymiaru pliku, nie sprawdzając go po eksporcie.
Każdy przykład tworzy nową figurę i zamyka ją po zapisie. Ponowne uruchomienie komórki nie powinno dokładać drugiej serii do poprzedniego rysunku. Funkcja zapisz zachowuje plik przed wyświetleniem i zamknięciem obiektu.
W01 od tabeli do rankingu
Ranking ma pokazać kolejność typowych poziomów drgań, nie „najgorsze urządzenie”. Obliczamy medianę i liczbę dostępnych pomiarów dla każdego urządzenia. Sortujemy niezaokrąglone wartości, a zaokrąglenie stosujemy dopiero w etykietach.
ranking = (df.groupby("urzadzenie", observed=True)
           .agg(n=("drgania", "count"),
                mediana=("drgania", "median"))
           .reset_index()
           .sort_values("mediana", ascending=False))
ranking.to_csv(
    TABLES / "M4_drgania_urzadzenie_podsumowanie.csv",
    index=False, encoding="utf-8"
)
display(ranking)

fig, ax = plt.subplots(figsize=(10, 5), layout="constrained")
kolory = ["#1F4E79"] * 3 + ["#9BAFBD"] * 5
slupki = ax.barh(ranking["urzadzenie"], ranking["mediana"],
                 color=kolory)
ax.invert_yaxis()
ax.set_xlim(0, 1.65)
ax.set_xlabel("Mediana drgań [mm/s]")
ax.set_ylabel("Urządzenie")
ax.set_title("U-05 ma najwyższą medianę drgań w tym zbiorze")
ax.bar_label(slupki, fmt="%.4f", padding=5)
ax.grid(axis="x", alpha=0.2)
ax.set_axisbelow(True)
zapisz(fig, "M4_W01_ranking_drgan.png")
Co zmieniają kolejne decyzje
Poziome słupki zostawiają miejsce na identyfikatory. Kolejność malejąca ułatwia porównanie pozycji. Wspólny początek w zerze sprawia, że długość słupka jest proporcjonalna do mediany. Delikatna siatka pomaga odczytać skalę, ale nie konkuruje z danymi.
Wyróżnienie trzech pierwszych pozycji wspiera zadanie, lecz nie jest jedynym nośnikiem informacji: kolejność, etykiety i wartości działają również w skali szarości. Legenda nie jest potrzebna, ponieważ pokazujemy jedną miarę, a kategorie są podpisane przy słupkach.
Limit 1,65 na osi jest dobrany do danych kursowych i pozostawia miejsce na wartości. Gdy użyjesz innego zbioru, sprawdź, czy żaden słupek ani napis nie wychodzi poza obszar. Ustawienie zakresu jest elementem kontroli wykresu, nie stałą regułą dla wszystkich danych.
Jak przeczytać ranking
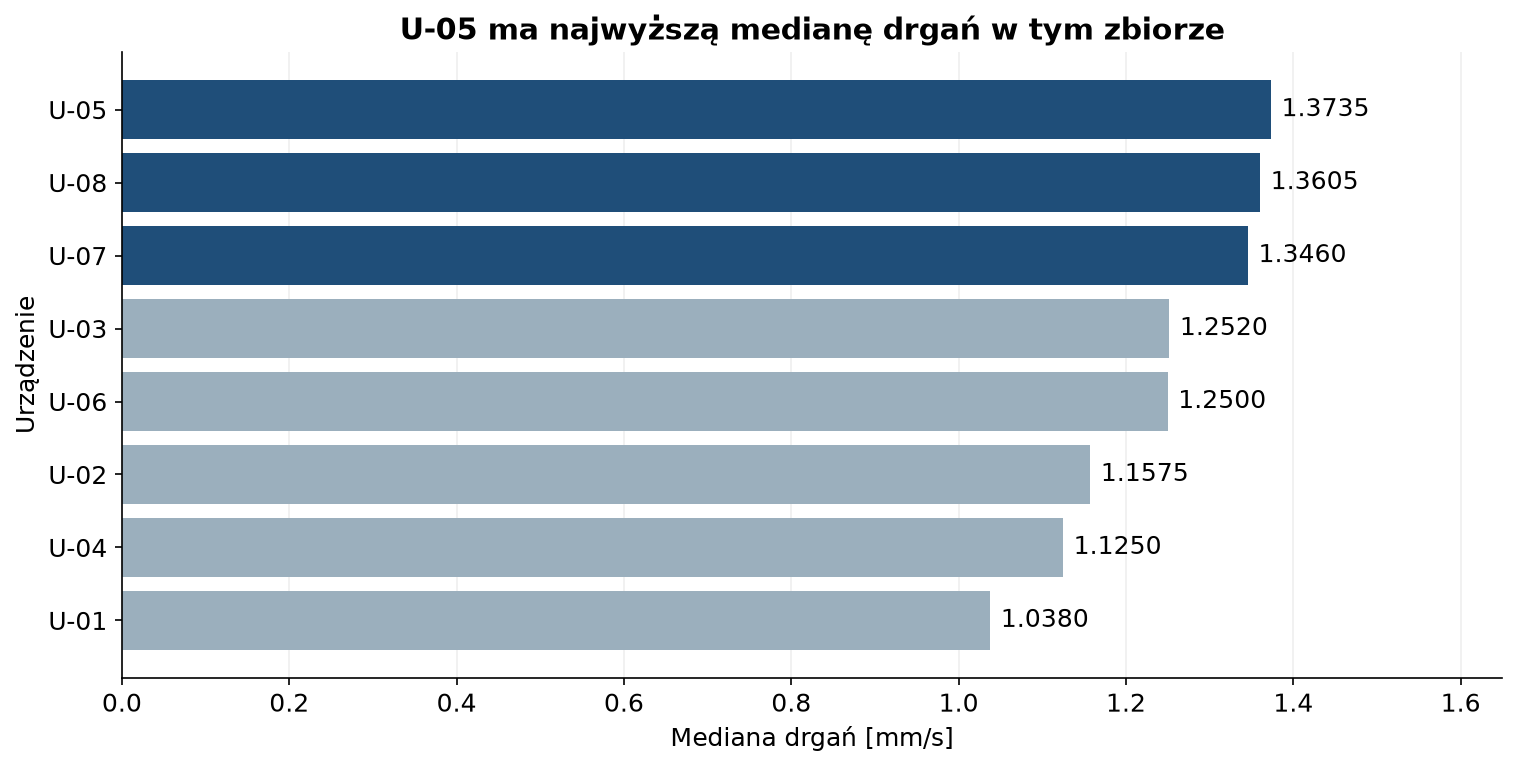
Rysunek 1. Mediany drgań ośmiu urządzeń, po 90 dostępnych pomiarów, 1.01–14.02.2026. Źródło: pomiary_clean.csv, grupowanie według urzadzenie. Słupki zaczynają się w zerze, a etykiety zachowują cztery miejsca po przecinku.
Najwyższą medianę ma U-05: 1,3735 mm/s. Kolejne są U-08 i U-07. Nie oznacza to, że różnice są istotne statystycznie ani że urządzenia wymagają takiej samej interwencji. Ranking nie pokazuje jeszcze rozrzutu, profilu pracy, dopuszczalnych poziomów dla danego typu urządzenia ani historii serwisowej.
Wysoki pojedynczy pomiar 4,850 mm/s nie jest medianą U-05. To ważne rozróżnienie: wykres podsumowania może pokazać typowy poziom, a jednocześnie ukryć pojedynczy sygnał wymagający sprawdzenia. W rozdziale 4 wrócimy do pełnego rozkładu.
Kontrola obrazu i ćwiczenie
Otwórz zapisany PNG, nie tylko podgląd komórki. Sprawdź tytuł, jednostkę, wszystkie osiem nazw oraz zgodność etykiet z tabelą. Następnie zmień kolejność na alfabetyczną i porównaj oba warianty. Dla rankingu wybierz kolejność wynikającą z wartości; dla stałego raportu urządzeń kolejność alfabetyczna może ułatwiać porównanie między wydaniami.
Sprawdź rozumienie 2
Dlaczego oś słupków powinna zaczynać się od zera? Czy dwie mediany równe po zaokrągleniu do dwóch miejsc muszą zajmować tę samą pozycję w rankingu?