Podręcznik uczestnika z objaśnieniami, przykładami i ćwiczeniami do samodzielnej nauki
| Site: | SEZAM - System Edukacyjnych Zasobów Akademickich i Multimedialnych |
| Course: | Python, LLM i analiza danych w notatnikach Jupyter |
| Book: | Podręcznik uczestnika z objaśnieniami, przykładami i ćwiczeniami do samodzielnej nauki |
| Printed by: | Gość |
| Date: | Wednesday, 18 November 2026, 10:39 PM |
Table of contents
- 1. Jak korzystać z podręcznika
- 2. Dane i rezultaty pracy
- 3. Pytanie dane i wybór wykresu
- 4. Fundamenty Matplotlib
- 5. Zmiany w czasie i porównania kategorii
- 6. Rozkład danych
- 7. Zależności i mapy ciepła
- 8. Narracja dostępność i kontrola jakości
- 9. Powtarzalny workflow modułu 4
- 10. Odpowiedzi do samooceny
- 11. Słownik pojęć
- 12. Wykaz plików i materiałów modułu
1. Jak korzystać z podręcznika
Dobry wykres pomaga odpowiedzieć na konkretne pytanie. Nie zastępuje sprawdzenia danych i nie daje prawa do mocniejszych wniosków niż te, na które pozwala analiza. W tym module przejdziesz od wyników eksploracji do czytelnego obrazu, a następnie do krótkiej, uczciwej opowieści o danych.
Podręcznik rozwija prezentację modułu 4 i pozwala uczyć się bez dostępu do internetu. Wykresy, ich interpretacje, zadania i odpowiedzi znajdują się w treści. Kod jest dodatkową ścieżką pracy: możesz najpierw przeczytać rozdział, a później odtworzyć przykład w notebooku. Do wykonywania kodu potrzebujesz lokalnego środowiska i plików kursowych.
Dwie ścieżki pracy
- Podczas lektury zatrzymuj się przy pytaniach „Sprawdź rozumienie”. Najpierw odpowiedz własnymi słowami, potem zajrzyj do odpowiedzi na końcu książki.
- Podczas ćwiczeń wykonuj bloki kodu kolejno w jednym notebooku M4_wizualizacja.ipynb. Zmienne z wcześniejszych rozdziałów są używane dalej. Nie jest potrzebna pamięć uruchomionych notebooków M2 ani M3.
- Po każdym wykresie porównaj obraz z tabelą, dopisz obserwację i ograniczenie. Ostatni rozdział pomoże Ci przygotować materiały do publikacji.
Przykłady są oparte na jednym zbiorze pomiarów eksploatacyjnych. Wyniki liczbowe dotyczą tej konkretnej wersji danych, a nie wszystkich możliwych instalacji przemysłowych. Pojedyncze pomiary tego samego urządzenia nie są automatycznie niezależnymi próbami statystycznymi.
2. Dane i rezultaty pracy
Punktem wyjścia jest data/processed/pomiary_clean.csv przygotowany w M2 i analizowany w M3. Nie czyścisz ponownie surowego CSV. Jeśli kontrola wejścia nie przejdzie, wracasz do decyzji i eksportu z M2.
Co oznacza jeden wiersz
Jeden rekord opisuje pomiar jednego urządzenia w jednej chwili. W zbiorze jest 720 rekordów i 14 kolumn, osiem urządzeń, po 90 rekordów na urządzenie. Okres obejmuje 1 stycznia – 14 lutego 2026 r., po dwa terminy dziennie. Para czas i urządzenie jest unikalna. Luty obejmuje tylko pierwszych 14 dni.
|
Wielkość |
Znaczenie w przykładach |
Dostępne wartości |
|---|---|---|
|
temperatura |
Temperatura w °C |
720 |
|
drgania |
Poziom drgań w mm/s |
720 |
|
energia |
Energia w kWh przypisana do rekordu pomiarowego |
718 |
|
produkcja |
Liczba sztuk przypisana do rekordu |
719 |
Dwa braki energii pozostają brakami. Jedna niedopuszczalna ujemna produkcja została w M2 zastąpiona brakiem. Pomiar drgań 4,850 mm/s pozostawiono do sprawdzenia, a nie usunięto jako rzekomą awarię. Wszystkie statusy mają wartość OK; ten zbiór nie pozwala porównywać grup OK i alarm.
Uporządkowany projekt
|
Miejsce |
Rola |
|---|---|
|
notebooks/M4_wizualizacja.ipynb |
Kod, tabele kontrolne, wykresy i komentarze |
|
data/processed/pomiary_clean.csv |
Niezmieniane wejście z M2 |
|
outputs/tables |
Tabele wynikowe M3 i nowe tabele M4 |
|
outputs/figures |
Sześć wykresów W01–W06 oraz mapa diagnostyczna |
W książce obowiązuje outputs, zgodnie z kartami pracy, zamiast skrótu output ze slajdów. Prefiksy M3 i M4 rozdzielają wyniki modułów. Pełny wykaz plików jest na końcu książki.
3. Pytanie dane i wybór wykresu
Zanim wybierzesz kolor lub wywołasz Matplotlib, zapisz pytanie i oczekiwaną odpowiedź. „Pokaż energię” nie określa jeszcze zadania. „Jak zmienia się mediana energii przypisanej do pomiaru w kolejnych dniach?” wskazuje zmienną, miarę podsumowania oraz porządek czasu. Dopiero tak sformułowane pytanie prowadzi do wykresu liniowego.
Pięć zadań wizualnych
|
Zadanie |
Odpowiedni punkt wyjścia |
Na co uważać |
|---|---|---|
|
Porównanie kategorii |
Słupki lub punkty na wspólnej skali |
Wspólna miara i początek słupków w zerze |
|
Zmiana w czasie |
Linia po uporządkowanych datach |
Poziom agregacji, luki i niepełne okresy |
|
Rozkład jednej wielkości |
Histogram lub wykres pudełkowy |
Przedziały, liczebność i obserwacje poza centrum |
|
Zależność dwóch wielkości |
Wykres punktowy |
Parowanie rekordów, grupy i nakładanie punktów |
|
Struktura całości |
Udziały lub słupki skumulowane |
Wspólny mianownik i rozłączne części całości |
Nie każdy wynik wymaga obrazu. Jedną dokładną wartość podaj w zdaniu, kilkanaście liczb — w tabeli. Wykres wybieraj, gdy ułatwia zauważenie relacji, porządku, zmienności lub nietypowego punktu.
Typ danych i poziom agregacji
Numer urządzenia jest identyfikatorem kategorii, mimo że zawiera cyfry. Łączenie urządzeń linią sugerowałoby nieistniejącą ciągłość. Czas ma naturalny porządek, ale rekordy ośmiu urządzeń nie tworzą jednej jednorodnej serii. Zdecyduj, czy pokazujesz osobne urządzenia, czy podsumowanie dnia.
Agregacja zmienia pytanie. Mediana energii mówi o typowej wartości rekordu; suma mówi o łącznej wartości dostępnych rekordów. Ani jedna, ani druga nie jest sama w sobie miarą efektywności. Do efektywności potrzebujesz jeszcze właściwie zdefiniowanego rezultatu i porównywalnych warunków pracy.
Sprawdź rozumienie 1
Masz porównać mediany drgań ośmiu urządzeń. Czy wykres liniowy po numerach urządzeń będzie dobrym wyborem? Zaproponuj lepszy i wyjaśnij, co ma oznaczać pojedynczy element wykresu.
Od wyniku M3 do planu wizualizacji
Wynik źródłowy to tabela lub jednoznacznie określone obliczenie, z którego powstaje obraz. Nie przepisuj liczb ze slajdu do listy w kodzie. Odtwórz podsumowanie z pliku wejściowego albo wczytaj sprawdzony eksport M3. Dzięki temu zmiana danych trafi także na wykres.
|
Wykres |
Powiązanie z M3 |
Pytanie i wynik źródłowy |
|---|---|---|
|
W01 |
M3-P03 |
Które urządzenia mają wyższe mediany drgań? Ranking ośmiu median oraz n |
|
W02 |
Rozwinięcie M3-P05 |
Jak układają się mediany energii w 45 dniach? Nowa tabela dzienna z Q1 Q3 i n |
|
W03 |
M3-P05 |
Jak różnią się mediany energii między halami w dwóch okresach? Tabela okres × lokalizacja |
|
W04 |
M3-P01 |
Jak wygląda rozkład drgań? Wszystkie dostępne wartości i jawne granice przedziałów |
|
W05 |
M3-P01 i M3-P03 |
Jak różnią się rozkłady drgań urządzeń? Dane grupowe i tabela n oraz median |
|
W06 |
M3-P06 |
Jak współwystępują temperatura i drgania? Kompletne pary z tych samych rekordów |
Mapa korelacji jest narzędziem diagnostycznym, nie siódmym wykresem końcowym. Pomaga wybrać parę do obejrzenia. Identyfikator W oznacza obraz w M4, a P — pytanie w M3. Nie muszą mieć tych samych numerów.
Pięć zdań przed kodem
Dla każdego planowanego obrazu zapisz: jakie pytanie zadajesz, skąd pochodzi wynik, jaki typ wykresu wybierasz, jakiej odpowiedzi szukasz i jakie ograniczenie trzeba zachować. Na tym etapie oczekiwana odpowiedź jest formą odpowiedzi, nie wymyślonym wynikiem. Zamiast „U-05 jest najgorsze” napisz „ustalę kolejność median, bez oceny stanu technicznego”.
W notebooku wykorzystaj tę mapę jako spis zadań. Po wykonaniu analizy zastąp oczekiwaną formę odpowiedzi rzeczywistą obserwacją. Jeżeli wykres nie odpowiada na pierwotne pytanie, popraw agregację lub pytanie i opisz zmianę. Nie maskuj rozbieżności atrakcyjnym tytułem.
Ćwiczenie przed uruchomieniem notebooka
Wybierz W02 i W03. Dla każdego określ jednostkę obserwacji, liczbę elementów na wykresie i informację tracącą się przy agregacji. Wróć do odpowiedzi po rozdziale 3.
4. Fundamenty Matplotlib
Matplotlib rozdziela figurę, obszar wykresu i osie liczbowe. Figure jest całym obrazem, Axes — obszarem, w którym rysujesz dane, a Axis odpowiada za skalę i podziałkę jednej osi. Nazwa Axes bywa myląca: jeden obiekt ax może zawierać zarówno oś poziomą, jak i pionową.
Przygotowanie notebooka
Utwórz notebook w katalogu notebooks i sprawdź katalog roboczy. Poniższy kod celowo zatrzyma się, jeżeli uruchomisz go z innego miejsca. Wówczas popraw katalog roboczy albo jawnie ustaw PROJECT_DIR na katalog swojego projektu. Nie omijaj błędu przez losowe dopisywanie kolejnych znaków ../.
from pathlib import Path
from hashlib import sha256
import numpy as np
import pandas as pd
import matplotlib
import matplotlib.pyplot as plt
import matplotlib.dates as mdates

print(Path.cwd())
print(pd.__version__, matplotlib.__version__)
assert Path.cwd().name == "notebooks"
PROJECT_DIR = Path.cwd().parent
TABLES = PROJECT_DIR / "outputs" / "tables"
FIGURES = PROJECT_DIR / "outputs" / "figures"
TABLES.mkdir(parents=True, exist_ok=True)
FIGURES.mkdir(parents=True, exist_ok=True)
plik = PROJECT_DIR / "data" / "processed" / "pomiary_clean.csv"
assert plik.is_file()
hash_wejscia = sha256(plik.read_bytes()).hexdigest()

plt.rcParams.update({
    "font.family": "DejaVu Sans", "font.size": 12,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.titleweight": "bold", "figure.facecolor": "white"
})

def zapisz(fig, nazwa):
    sciezka = FIGURES / nazwa
    fig.savefig(sciezka, dpi=150, bbox_inches="tight",
                facecolor="white")
    plt.show()
    plt.close(fig)
    return sciezka
Zapisane wersje bibliotek pomogą odtworzyć pracę. Przykłady korzystają z Pandas oraz Matplotlib; parametr tick_labels w rozdziale 4 wymaga Matplotlib 3.9 lub nowszego. Samodzielna lektura książki nie wymaga instalacji. Do pracy offline przygotuj środowisko i pliki przed odłączeniem internetu.
Odczyt danych bez zmiany decyzji z M2
CSV przechowuje tekst, nie pełny schemat typów Pandas. Dlatego przy odczycie ponownie określamy typy i daty. Jest to odtworzenie reprezentacji danych, a nie ponowne rozstrzyganie braków, duplikatów czy nietypowych pomiarów.
typy = {
    "rok_miesiac": "string", "urzadzenie": "string",
    "typ_urzadzenia": "string", "lokalizacja": "string",
    "moc_nominalna_kw": "float64",
    "wiek_urzadzenia_dni": "Int64",
    "temperatura": "float64", "drgania": "float64",
    "energia": "float64", "produkcja": "Int64",
    "tryb": "category", "status": "category"
}
df = pd.read_csv(
    plik, dtype=typy, parse_dates=["czas", "data_instalacji"],
    encoding="utf-8"
)
assert df.shape == (720, 14)
assert df[["czas", "urzadzenie"]].notna().all().all()
assert not df.duplicated(["czas", "urzadzenie"]).any()
assert df["urzadzenie"].value_counts().eq(90).all()
assert df["urzadzenie"].nunique() == 8
assert df["czas"].dt.normalize().nunique() == 45
assert df["energia"].isna().sum() == 2
assert df["produkcja"].isna().sum() == 1
assert df[["temperatura", "drgania"]].notna().all().all()
display(df.head(3))
Oczekiwane liczby dotyczą zbioru kursowego. W innym projekcie ustalasz je z dokumentacji źródła. Asercje nie zastępują przeczytania słownika ani sprawdzenia zakresu czasu: potwierdzają wybrane warunki, nie całą jakość danych.
Jedna figura jedno świadome zadanie
Polecenie fig, ax = plt.subplots() tworzy figurę i obszar wykresu. Dalej korzystasz z metod ax, takich jak barh(), set_xlabel() czy set_title(). Taki zapis jasno wskazuje, który obszar zmieniasz, szczególnie gdy jedna figura zawiera dwa panele. Nie miesza ustawień przypadkowo aktywnych wykresów.
Parametr figsize podaje wymiary w calach, a dpi liczbę pikseli na cal. Figura 10 × 5 cali przy 150 dpi ma nominalnie 1500 × 750 pikseli. Przy bbox_inches="tight" wynikowy rozmiar może być inny, ponieważ zapis przycina obszar do zawartości. Nie obiecuj stałego wymiaru pliku, nie sprawdzając go po eksporcie.
Każdy przykład tworzy nową figurę i zamyka ją po zapisie. Ponowne uruchomienie komórki nie powinno dokładać drugiej serii do poprzedniego rysunku. Funkcja zapisz zachowuje plik przed wyświetleniem i zamknięciem obiektu.
W01 od tabeli do rankingu
Ranking ma pokazać kolejność typowych poziomów drgań, nie „najgorsze urządzenie”. Obliczamy medianę i liczbę dostępnych pomiarów dla każdego urządzenia. Sortujemy niezaokrąglone wartości, a zaokrąglenie stosujemy dopiero w etykietach.
ranking = (df.groupby("urzadzenie", observed=True)
           .agg(n=("drgania", "count"),
                mediana=("drgania", "median"))
           .reset_index()
           .sort_values("mediana", ascending=False))
ranking.to_csv(
    TABLES / "M4_drgania_urzadzenie_podsumowanie.csv",
    index=False, encoding="utf-8"
)
display(ranking)

fig, ax = plt.subplots(figsize=(10, 5), layout="constrained")
kolory = ["#1F4E79"] * 3 + ["#9BAFBD"] * 5
slupki = ax.barh(ranking["urzadzenie"], ranking["mediana"],
                 color=kolory)
ax.invert_yaxis()
ax.set_xlim(0, 1.65)
ax.set_xlabel("Mediana drgań [mm/s]")
ax.set_ylabel("Urządzenie")
ax.set_title("U-05 ma najwyższą medianę drgań w tym zbiorze")
ax.bar_label(slupki, fmt="%.4f", padding=5)
ax.grid(axis="x", alpha=0.2)
ax.set_axisbelow(True)
zapisz(fig, "M4_W01_ranking_drgan.png")
Co zmieniają kolejne decyzje
Poziome słupki zostawiają miejsce na identyfikatory. Kolejność malejąca ułatwia porównanie pozycji. Wspólny początek w zerze sprawia, że długość słupka jest proporcjonalna do mediany. Delikatna siatka pomaga odczytać skalę, ale nie konkuruje z danymi.
Wyróżnienie trzech pierwszych pozycji wspiera zadanie, lecz nie jest jedynym nośnikiem informacji: kolejność, etykiety i wartości działają również w skali szarości. Legenda nie jest potrzebna, ponieważ pokazujemy jedną miarę, a kategorie są podpisane przy słupkach.
Limit 1,65 na osi jest dobrany do danych kursowych i pozostawia miejsce na wartości. Gdy użyjesz innego zbioru, sprawdź, czy żaden słupek ani napis nie wychodzi poza obszar. Ustawienie zakresu jest elementem kontroli wykresu, nie stałą regułą dla wszystkich danych.
Jak przeczytać ranking
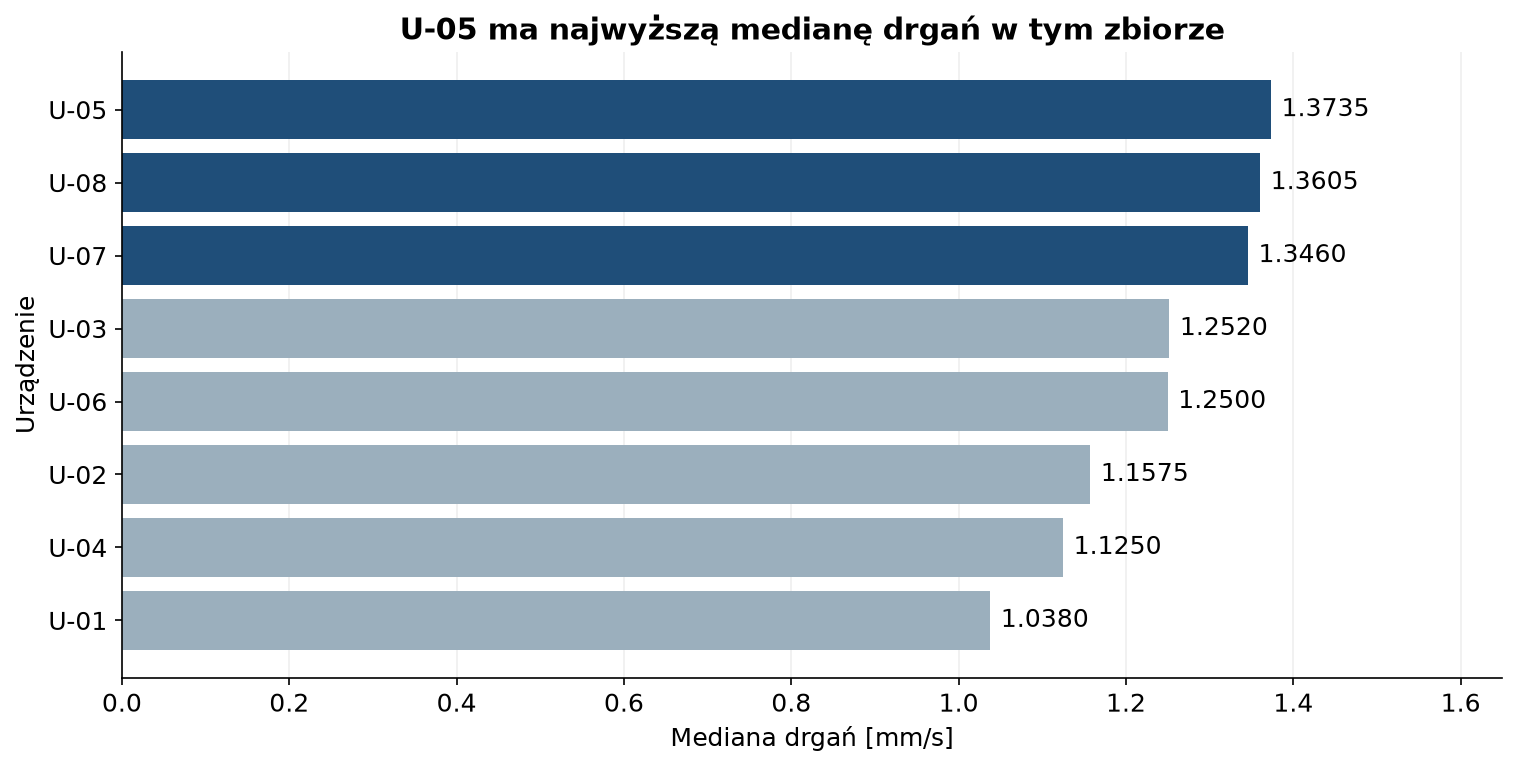
Rysunek 1. Mediany drgań ośmiu urządzeń, po 90 dostępnych pomiarów, 1.01–14.02.2026. Źródło: pomiary_clean.csv, grupowanie według urzadzenie. Słupki zaczynają się w zerze, a etykiety zachowują cztery miejsca po przecinku.
Najwyższą medianę ma U-05: 1,3735 mm/s. Kolejne są U-08 i U-07. Nie oznacza to, że różnice są istotne statystycznie ani że urządzenia wymagają takiej samej interwencji. Ranking nie pokazuje jeszcze rozrzutu, profilu pracy, dopuszczalnych poziomów dla danego typu urządzenia ani historii serwisowej.
Wysoki pojedynczy pomiar 4,850 mm/s nie jest medianą U-05. To ważne rozróżnienie: wykres podsumowania może pokazać typowy poziom, a jednocześnie ukryć pojedynczy sygnał wymagający sprawdzenia. W rozdziale 4 wrócimy do pełnego rozkładu.
Kontrola obrazu i ćwiczenie
Otwórz zapisany PNG, nie tylko podgląd komórki. Sprawdź tytuł, jednostkę, wszystkie osiem nazw oraz zgodność etykiet z tabelą. Następnie zmień kolejność na alfabetyczną i porównaj oba warianty. Dla rankingu wybierz kolejność wynikającą z wartości; dla stałego raportu urządzeń kolejność alfabetyczna może ułatwiać porównanie między wydaniami.
Sprawdź rozumienie 2
Dlaczego oś słupków powinna zaczynać się od zera? Czy dwie mediany równe po zaokrągleniu do dwóch miejsc muszą zajmować tę samą pozycję w rankingu?
5. Zmiany w czasie i porównania kategorii
Linia podkreśla kolejność i ciągłość, dlatego nadaje się do czasu. Najpierw wybierasz jednak poziom agregacji. W W02 jeden punkt oznacza medianę dostępnych pomiarów energii w dniu, ze wszystkich ośmiu urządzeń. Nie jest to suma energii zużytej tego dnia ani pomiar pojedynczego urządzenia.
energia_dzien = (
    df.assign(dzien=df["czas"].dt.normalize())
    .groupby("dzien")["energia"]
    .agg(n="count", mediana="median",
         q1=lambda s: s.quantile(0.25),
         q3=lambda s: s.quantile(0.75))
    .reset_index().sort_values("dzien")
)
assert len(energia_dzien) == 45
assert energia_dzien["n"].sum() == 718
assert energia_dzien["n"].between(15, 16).all()
energia_dzien.to_csv(TABLES / "M4_energia_dzien.csv",
                     index=False, encoding="utf-8")

fig, ax = plt.subplots(figsize=(10, 5), layout="constrained")
ax.fill_between(energia_dzien["dzien"], energia_dzien["q1"],
                energia_dzien["q3"], color="#9BAFBD",
                alpha=0.45, label="Środkowe 50% wartości Q1–Q3")
ax.plot(energia_dzien["dzien"], energia_dzien["mediana"],
        color="#1F4E79", marker="o", markersize=3,
        linewidth=1.6, label="Mediana")
lokator = mdates.AutoDateLocator(minticks=4, maxticks=7)
ax.xaxis.set_major_locator(lokator)
ax.xaxis.set_major_formatter(mdates.DateFormatter("%d.%m"))
ax.set(xlabel="Dzień w 2026 roku",
       ylabel="Energia przypisana do pomiaru [kWh]",
       title="Dzienne mediany energii mieszczą się w 13,75–14,54 kWh")
ax.grid(axis="y", alpha=0.2)
ax.legend(loc="lower left", fontsize=10)
zapisz(fig, "M4_W02_energia_dzien.png")
Metoda count liczy istniejące wartości energii, nie wszystkie rekordy. W dniach 12 i 21 stycznia n wynosi 15, w pozostałych 16. Pas Q1–Q3 opisuje rozrzut środkowej połowy wartości w danym dniu. Nie jest przedziałem ufności mediany, błędem pomiarowym ani zakresem prognozy.
W02 czas bez dopisywania trendu
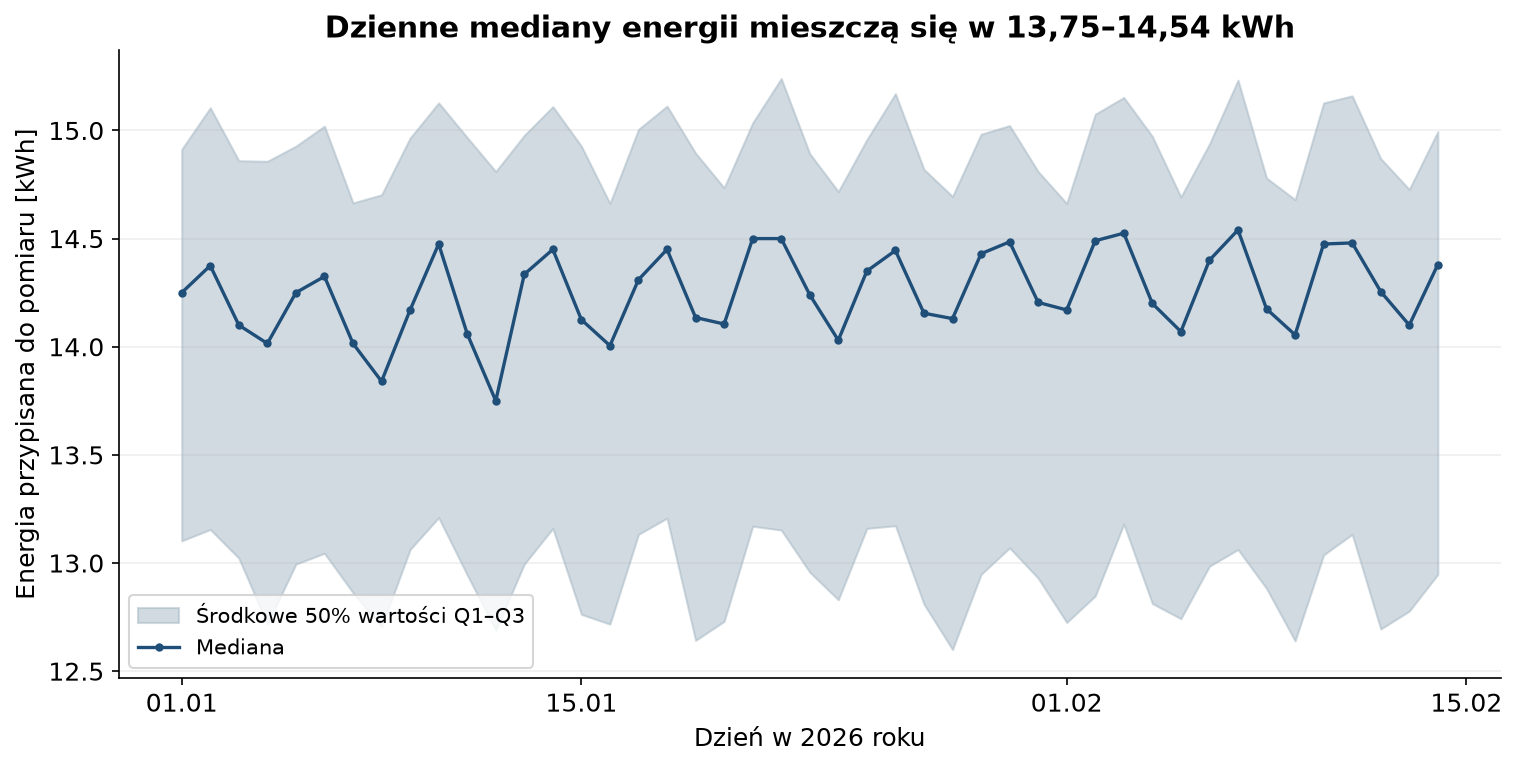
Rysunek 2. Mediana i kwartyle energii przypisanej do rekordu pomiarowego w kolejnych dniach. Źródło: pomiary_clean.csv, 718 dostępnych wartości; n = 15–16 dziennie. Pas oznacza Q1–Q3, a zakres czasu obejmuje 45 dni.
Dzienne mediany wahają się między 13,75 a 14,54 kWh. Wykres nie uzasadnia zdania „zużycie stale rośnie” ani prognozy na kolejne miesiące. Krótki okres i agregacja ośmiu urządzeń ograniczają interpretację.
Skala i luki są częścią komunikatu
Na wykresie liniowym oś pionowa nie zawsze musi zaczynać się w zerze, ale musi być czytelnie opisana. Wąski zakres i wydłużony pionowo obraz mogą wyolbrzymić drobne wahania. Sprawdź szerszy zakres i oceń, czy tytuł nadal brzmi uczciwie.
Sortowanie dat jest niezbędne. Gdy brakuje całego dnia, zwykłe połączenie pozostałych punktów może zasugerować ciągłą obserwację. W takim przypadku odtwórz kalendarz, pozostaw brak w wartości i świadomie pokaż przerwę. W zbiorze kursowym są wszystkie 45 dni; dwa braki dotyczą pojedynczych pomiarów, a nie całych dni.
Ćwiczenie w notebooku
Zbuduj analogiczną tabelę dla produkcji. Użyj liczby dostępnych wartości, mediany i kwartylów. Zapisz wykres jako M4_C03_produkcja_dzien.png. Wyjaśnij, dlaczego tytuł „Dzienna produkcja” byłby zbyt mało precyzyjny, gdy na osi pionowej pokazujesz medianę liczby sztuk przypisanych do rekordu.
W03 porównanie hal w dwóch okresach
Eksport M3_P05_energia_miesiac_lokalizacja.csv ma sześć wierszy, po jednym dla pary okres i lokalizacja. To format wierszowy, nie gotowa szeroka macierz. Metoda pivot zmienia układ bez ponownej agregacji; powtórzona para kluczy powinna zatrzymać tę operację.
m3_energia = pd.read_csv(
    TABLES / "M3_P05_energia_miesiac_lokalizacja.csv",
    dtype={"rok_miesiac": "string", "lokalizacja": "string"}
)
assert not m3_energia.duplicated(
    ["rok_miesiac", "lokalizacja"]).any()
energia_ml = m3_energia.pivot(
    index="lokalizacja", columns="rok_miesiac",
    values="energia_mediana"
).sort_index().sort_index(axis=1)
kontrola_ml = df.pivot_table(
    index="lokalizacja", columns="rok_miesiac",
    values="energia", aggfunc="median", observed=True
).sort_index().sort_index(axis=1)
pd.testing.assert_frame_equal(energia_ml, kontrola_ml)
display(m3_energia)

fig, ax = plt.subplots(figsize=(10, 5), layout="constrained")
x = np.arange(len(energia_ml))
for j, (okres, etykieta) in enumerate([
    ("2026-01", "1–31 stycznia"), ("2026-02", "1–14 lutego")
]):
    slupki = ax.bar(
        x + (j - 0.5) * 0.36, energia_ml[okres], width=0.36,
        color=["#1F4E79", "#A9BCCB"][j],
        hatch=["", "//"][j], edgecolor="#34495E", label=etykieta
    )
    ax.bar_label(slupki, fmt="%.3f", padding=3, fontsize=10)
ax.set_xticks(x, energia_ml.index)
ax.set(xlabel="Lokalizacja", ylabel="Mediana energii [kWh/pomiar]",
       ylim=(0, 18), title="Hala A ma niższe mediany w obu okresach")
ax.legend(loc="upper center", ncols=2, fontsize=10)
ax.grid(axis="y", alpha=0.2)
ax.set_axisbelow(True)
zapisz(fig, "M4_W03_energia_okres_lokalizacja.png")
Porównanie ze świeżym obliczeniem sprawdza, czy eksport M3 odpowiada użytemu wejściu. Gdy pliku brakuje lub wyniki są inne, odtwórz eksport w M3 i wyjaśnij różnicę. Nie zastępuj kontroli ręcznie wpisanymi wartościami z prezentacji.
Nie dodawaj oznaczeń niepewności bez definicji. Jeśli pokazujesz Q1 i Q3, nazwij je kwartylami. Zapis mediana ± IQR nie odtwarza ich położenia: kwartyle nie muszą być symetryczne względem mediany.
W03 mediana nie jest efektywnością
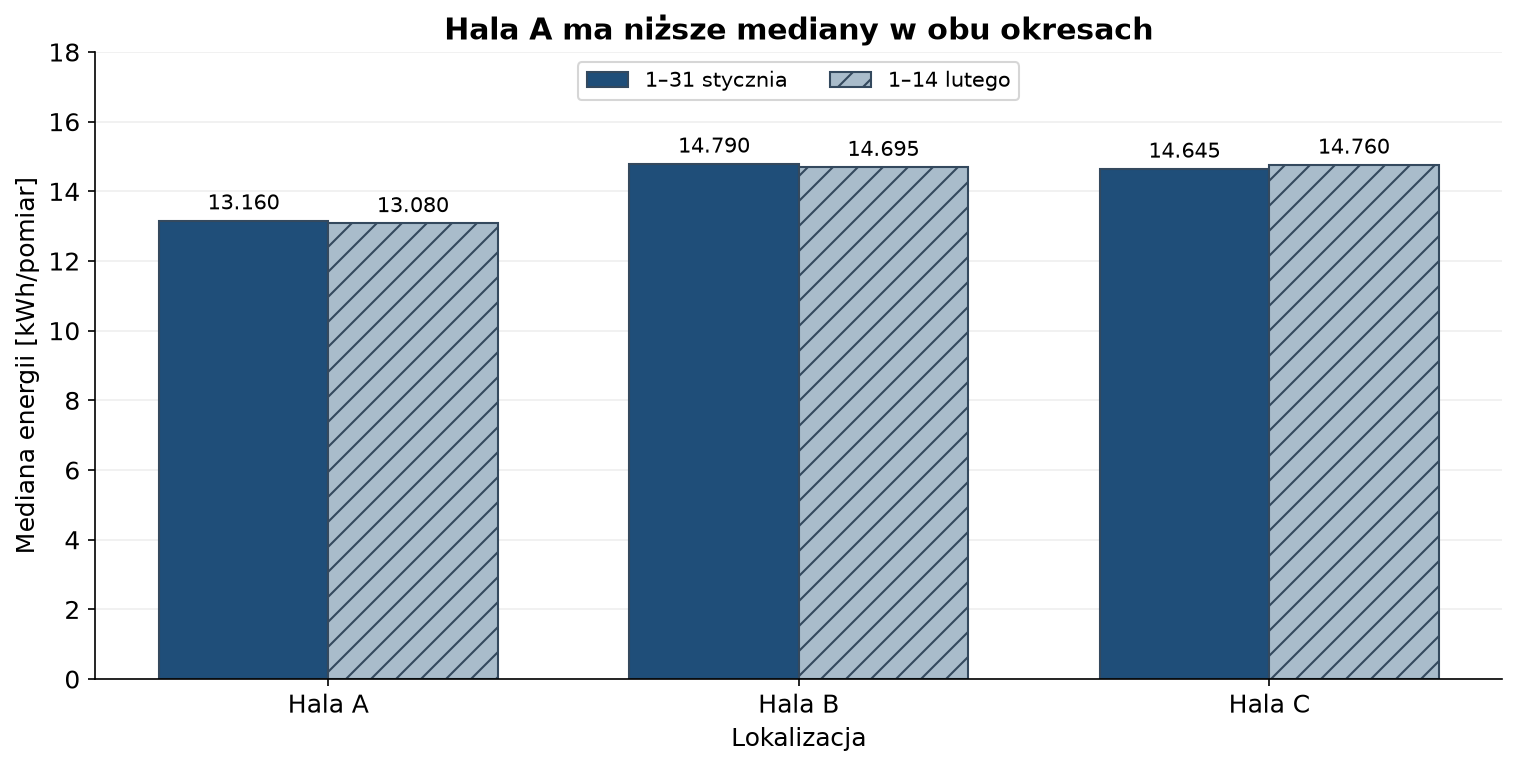
Rysunek 3. Mediany energii według lokalizacji i okresu. Źródło: M3_P05_energia_miesiac_lokalizacja.csv, potwierdzone na pomiary_clean.csv. Liczby dostępnych wartości w styczniu: Hala A 186, B 184, C 124; w lutym: A 84, B 84, C 56. Luty obejmuje dni 1–14.
Hala A ma niższe mediany w obu przedstawionych okresach. To opis wartości energii przypisanej do rekordu, a nie potwierdzenie większej efektywności hali. Hale różnią się składem urządzeń, a ocena efektywności wymagałaby również wyniku pracy i porównywalnych warunków.
Dwa okresy nie wystarczają, by mówić o trwałym trendzie. Niepełny luty powinien być oznaczony w legendzie lub podpisie, nawet gdy porównujesz mediany zamiast sum. Mediana nie rośnie automatycznie wraz z długością okresu, ale wybór obserwowanych dni nadal może wpływać na wynik.
Czytelne porównanie wielu serii
Grupowane słupki pozwalają porównać dwie wartości dla każdej hali. Dwie barwy wspieramy kreskowaniem, aby okresy można było rozróżnić również bez koloru. Trzy hale i dwa okresy pozostają czytelne; przy kilkudziesięciu kategoriach lepsze mogą być osobne panele lub zawężenie pytania.
Sprawdź rozumienie 3
Co oznacza pas Q1–Q3 na W02? Dlaczego podpis W03 musi wskazać niepełny luty, choć porównujesz mediany, a nie sumy? Odpowiedz, nie używając słowa „błąd” jako zamiennika rozrzutu.
6. Rozkład danych
Mediana mówi o położeniu środka, ale nie pokazuje całego kształtu danych. Dwa zbiory mogą mieć podobne mediany i zupełnie różny rozrzut. Histogram dzieli oś liczbową na przedziały i zlicza wartości w każdym z nich. Sąsiednie słupki opisują sąsiednie zakresy tej samej wielkości, a nie osobne kategorie.
W04 pełny zakres i jawne zbliżenie
W zbiorze 719 wartości drgań leży poniżej 1,75 mm/s, a jedna wynosi 4,850 mm/s. Pełny zakres pokazuje odseparowany pomiar, lecz utrudnia odczytanie centrum. Dlatego używamy dwóch paneli z tymi samymi granicami przedziałów i tą samą skalą liczebności. Prawy panel jest wyraźnie opisanym zbliżeniem.
drgania = df["drgania"].dropna().to_numpy()
granice = np.histogram_bin_edges(drgania, bins="fd")
liczebnosci, _ = np.histogram(drgania, bins=granice)
assert liczebnosci.sum() == 720
q1, mediana, q3 = np.quantile(drgania, [0.25, 0.5, 0.75])
print(len(granice) - 1, q1, mediana, q3)

fig, osie = plt.subplots(1, 2, figsize=(11, 5), sharey=True,
                        layout="constrained")
for ax in osie:
    ax.hist(drgania, bins=granice, color="#1F4E79",
            edgecolor="white", linewidth=0.5)
    ax.axvline(mediana, color="#A64824", linestyle="--",
               linewidth=1.5, label="Mediana 1,2425")
    ax.set_xlabel("Drgania [mm/s]")
    ax.grid(axis="y", alpha=0.2)
    ax.set_axisbelow(True)
osie[0].set(ylabel="Liczba pomiarów", title="Pełny zakres n = 720")
osie[0].annotate("4,850 mm/s", xy=(4.85, 1), xytext=(3.0, 25),
                 arrowprops={"arrowstyle": "->"}, fontsize=11)
osie[1].set(xlim=(0.7, 1.8), title="Zbliżenie 0,7–1,8 mm/s")
osie[1].legend(fontsize=10)
fig.suptitle("Rozkład drgań i jeden odseparowany pomiar")
zapisz(fig, "M4_W04_histogram_drgania.png")
Reguła FD dobiera szerokość przedziału z rozstępu międzykwartylowego i liczebności. Jest punktem wyjścia, nie gwarancją najlepszego obrazu. W tym zbiorze otrzymujemy 84 przedziały w pełnym zakresie. Porównaj również 15 i 30 przedziałów: zbyt szerokie mogą ukryć strukturę, a zbyt wąskie nadmiernie eksponować drobne wahania liczebności.
Jak czytać histogram
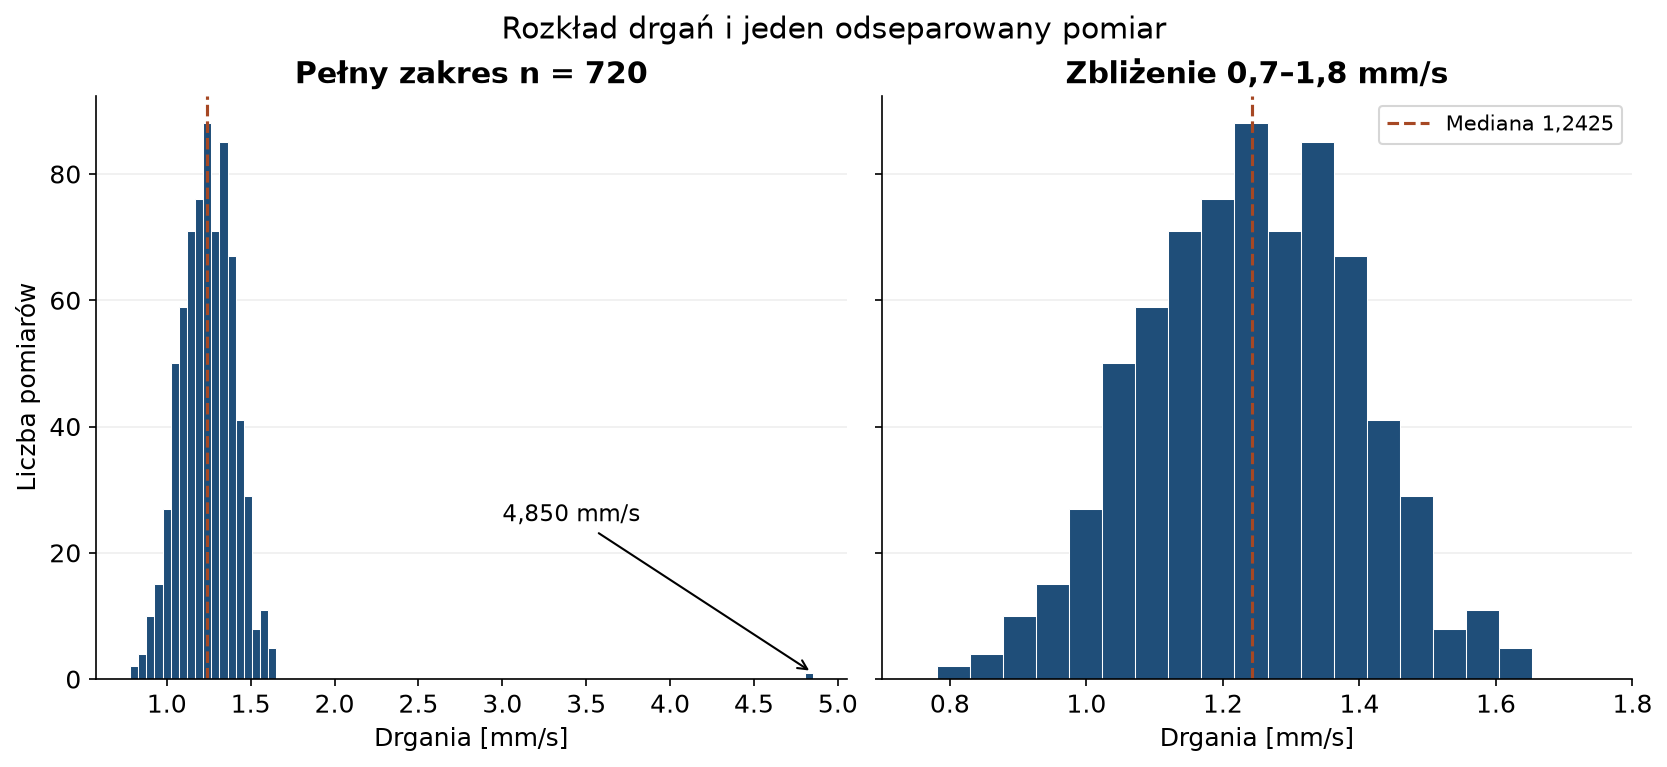
Rysunek 4. Rozkład 720 pomiarów drgań, 1.01–14.02.2026. Źródło: pomiary_clean.csv. Oba panele używają tych samych 84 przedziałów i wspólnej skali pionowej. Zbliżenie po prawej nie obejmuje jednego pomiaru 4,850 mm/s; jest on widoczny w pełnym zakresie po lewej.
W przedziale od 1,0 do 1,5 mm/s mieści się 649 pomiarów. Pojedyncza wysoka wartość wydłuża prawy zakres rozkładu. Nie usuwa się jej po to, aby centrum „lepiej wyglądało”. Zbliżenie jest uczciwe, gdy pełny zakres pozostaje dostępny, a pominięcie jest jawnie opisane.
Przedziały i liczebności
Wysokość słupka oznacza liczbę pomiarów w przedziale. Zmiana granic może przesunąć wartości do sąsiednich słupków i zmienić wrażenie kształtu. Dlatego przy porównywaniu grup stosuj te same granice, a przy różnych liczebnościach rozważ udział lub gęstość. Gęstość nie oznacza liczby rekordów; jej interpretacja uwzględnia także szerokość przedziału.
Histogram nie pokazuje kolejności czasu ani identyfikatora każdego pomiaru. Nie dowiesz się z niego, czy wysoka wartość wystąpiła raz, w jakim trybie pracowało urządzenie ani co działo się przed zdarzeniem, dopóki nie wrócisz do rekordów źródłowych. W tym przykładzie adnotacja wskazuje wartość, nie diagnozę jej przyczyny.
Ćwiczenie w notebooku
Narysuj rozkład temperatury i porównaj 10, 20 oraz 40 przedziałów. Wybierz jeden wariant, zapisz go jako M4_C04_histogram_temperatura.png i uzasadnij wybór. Sprawdź, czy suma liczebności wynosi 720. Nie opisuj wielomodalności tylko dlatego, że jeden wariant ma kilka drobnych lokalnych szczytów.
W05 porównanie rozkładów urządzeń
Wykres pudełkowy porządkuje wiele rozkładów na wspólnej skali. Pudełko obejmuje Q1–Q3, kreska w środku oznacza medianę. Przy whis=1.5 wąsy kończą się na najbardziej skrajnych obserwacjach mieszczących się w granicach Q1 − 1,5 × IQR oraz Q3 + 1,5 × IQR. Pozostałe punkty są rysowane osobno.
Wąsy nie muszą sięgać samych granic reguły i nie oznaczają tu minimum oraz maksimum całego zbioru. Granice liczymy oddzielnie dla każdego urządzenia. Dlatego status punktu względem lokalnego pudełka może być inny niż względem rozkładu wszystkich urządzeń razem.
kolejnosc = ranking.sort_values("mediana")["urzadzenie"].tolist()
grupy = [df.loc[df["urzadzenie"].eq(u), "drgania"].dropna()
         .to_numpy() for u in kolejnosc]
etykiety = [u + "\nn=90" for u in kolejnosc]
fig, osie = plt.subplots(1, 2, figsize=(11, 5),
                        layout="constrained")
for ax in osie:
    ax.boxplot(
        grupy, tick_labels=etykiety, whis=1.5, showfliers=True,
        patch_artist=True,
        boxprops={"facecolor": "#B7CBD9", "edgecolor": "#1F4E79"},
        medianprops={"color": "#A64824", "linewidth": 1.8},
        flierprops={"marker": "o", "markersize": 3}
    )
    ax.set(xlabel="Urządzenie", ylabel="Drgania [mm/s]")
    ax.tick_params(axis="x", labelsize=12)
    ax.grid(axis="y", alpha=0.2)
osie[0].set(ylim=(0.65, 5.1), title="Pełny zakres")
osie[1].set(ylim=(0.7, 1.75), title="Zbliżenie 0,70–1,75 mm/s")
fig.suptitle("Urządzenia różnią się położeniem rozkładów drgań")
zapisz(fig, "M4_W05_boxplot_drgania_urzadzenie.png")
Kolejność według median ułatwia powiązanie z W01. W obrębie każdego panelu wszystkie urządzenia mają tę samą skalę. Panele mają różne zakresy pionowe, jawnie podane w tytułach. Nie porównuj wysokości pudełka z lewego panelu z wysokością pudełka z prawego.
Co dodaje wykres pudełkowy
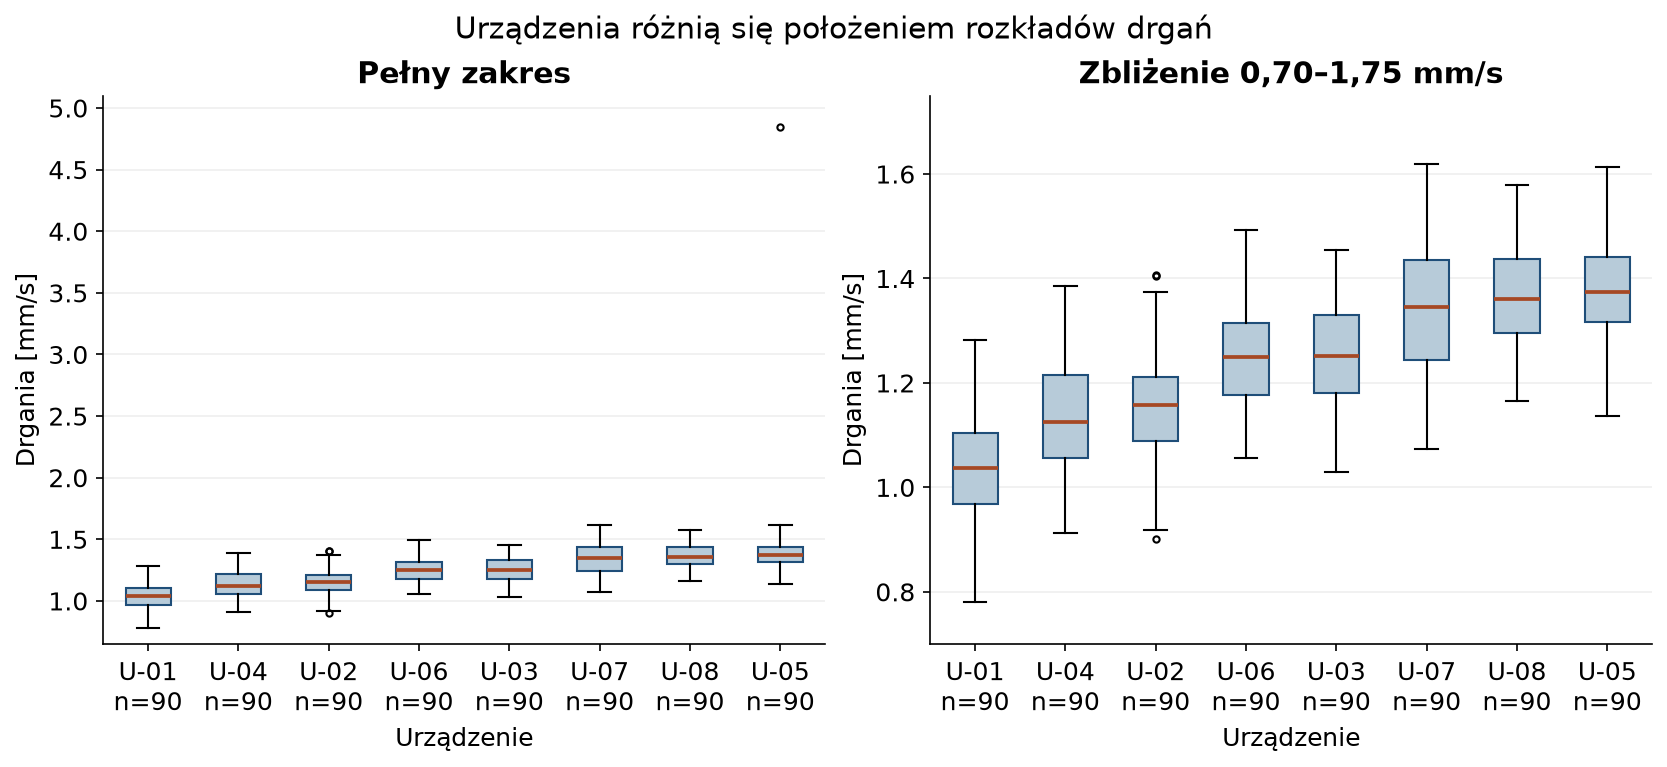
Rysunek 5. Rozkłady drgań według urządzenia, n = 90 w każdej grupie, 1.01–14.02.2026. Źródło: pomiary_clean.csv. Pudełka Q1–Q3, mediany, wąsy według reguły 1,5 × IQR. Zbliżenie nie obejmuje punktu U-05 równego 4,850 mm/s, widocznego po lewej.
Ranking W01 pokazał tylko osiem median. Tutaj widzisz również rozrzut środkowej części danych i punkty poza lokalnymi wąsami. Nie uznawaj jednak nakładania pudełek lub jego braku za gotowy test istotności różnic. Obraz opisowy nie zastępuje odpowiedniego modelu statystycznego.
Nietypowość zależy od kontekstu
Dla wszystkich drgań razem Q1 wynosi 1,1320, Q3 wynosi 1,3515, a IQR 0,2195 mm/s. Reguła globalna wskazuje między innymi niskie wartości 0,781 i 0,786 mm/s. Obie pochodzą z U-01 i mieszczą się w jego lokalnych granicach. Nie są tym samym rodzajem sygnału co odseparowany wysoki wynik U-05.
Punkt poza wąsem nie jest automatycznie błędem czujnika. Pozostaw wartość i opisz potrzebę sprawdzenia źródła, warunków pracy lub zapisu zdarzeń. Nie zmieniaj danych, aby pozbyć się punktów z wykresu.
Sprawdź rozumienie 4
Czy wąsy na tym wykresie muszą sięgać minimum i maksimum grupy? Czy punkt oznaczony jako nietypowy dla wszystkich urządzeń razem musi leżeć poza wąsami swojego urządzenia? Wyjaśnij obie odpowiedzi na przykładzie U-01.
7. Zależności i mapy ciepła
Wykres punktowy pokazuje pary wartości. Jeden punkt W06 łączy temperaturę i drgania z tego samego rekordu. Nie sortuj obu kolumn osobno przed rysowaniem: zniszczyłoby to rzeczywiste pary i mogło stworzyć sztuczną zależność. Braki usuwaj tylko z pól potrzebnych w danym porównaniu.
W06 temperatura i drgania
pary = df[["urzadzenie", "temperatura", "drgania"]].dropna()
r_pelny = pary["temperatura"].corr(pary["drgania"])
assert len(pary) == 720
skrajny = pary.loc[pary["drgania"].idxmax()]

fig, ax = plt.subplots(figsize=(10, 5), layout="constrained")
ax.scatter(pary["temperatura"], pary["drgania"],
           s=24, alpha=0.4, color="#1F4E79", edgecolors="none")
ax.annotate(
    "U-05: 4,850 mm/s\nwartość do sprawdzenia",
    xy=(skrajny["temperatura"], skrajny["drgania"]),
    xytext=(54, 3.8), fontsize=11,
    arrowprops={"arrowstyle": "->", "color": "#A64824"}
)
ax.set(xlabel="Temperatura [°C]", ylabel="Drgania [mm/s]",
       title=f"Dodatnia zależność w całym zbiorze: r = {r_pelny:.3f}")
ax.text(0.02, 0.96, f"n = {len(pary)} kompletnych par",
        transform=ax.transAxes, va="top", fontsize=11)
ax.grid(alpha=0.2)
ax.set_axisbelow(True)
zapisz(fig, "M4_W06_temperatura_drgania.png")
Parametr s określa pole znacznika w jednostkach punktów typograficznych do kwadratu. Wszystkie znaczniki mają tu taki sam rozmiar, więc rozmiar nie oznacza trzeciej zmiennej. Przezroczystość alpha ułatwia zobaczenie zagęszczeń, gdy punkty się nakładają. Nie pozwala jednak dokładnie policzyć wszystkich obserwacji na obrazie.
Korelacja to opis współzmienności
Współczynnik Pearsona r opisuje kierunek i siłę zależności liniowej. Wynosi od −1 do 1, ale wartość bliska zeru nie wyklucza zależności nieliniowej. Dodatnie r nie dowodzi, że wzrost temperatury powoduje wzrost drgań. Wspólne zmiany mogą wynikać z innych warunków, różnic urządzeń lub struktury zbioru.
Wynik globalny miesza pomiary wielu urządzeń i wielokrotne obserwacje tych samych urządzeń. To użyteczny sygnał do dalszego oglądania danych, a nie gotowy model przyczynowy lub podstawa diagnozy technicznej.
Jak czytać chmurę punktów
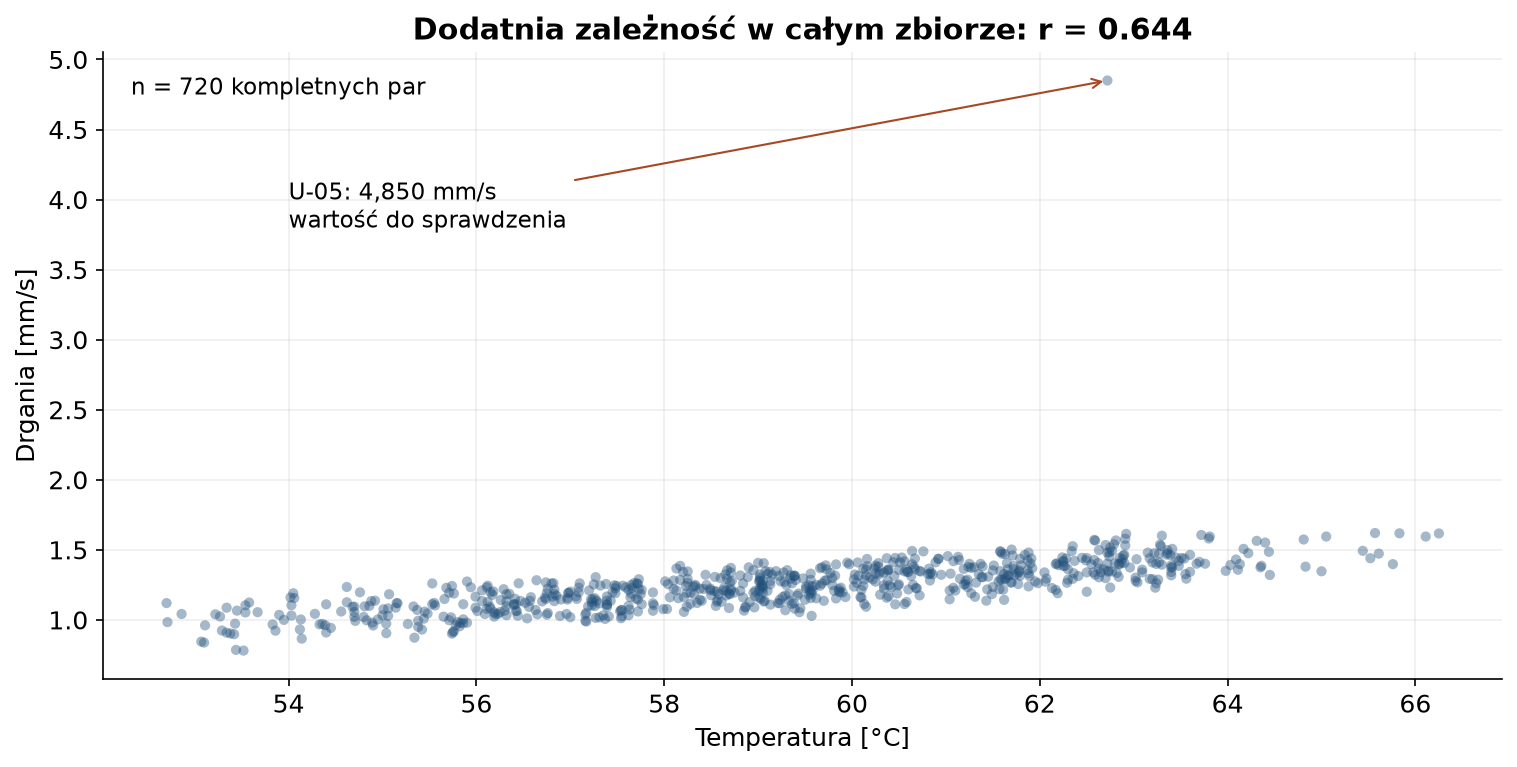
Rysunek 6. Temperatura i drgania w 720 kompletnych parach, 1.01–14.02.2026. Źródło: pomiary_clean.csv. Globalna korelacja Pearsona r ≈ 0,644; punkt 4,850 mm/s zachowany. Wynik nie oznacza związku przyczynowego.
Sprawdzenie wrażliwości bez zmiany źródła
Porównanie wyniku z pojedynczym skrajnym punktem i bez niego pokazuje wrażliwość miary. Nie jest pozwoleniem na usunięcie niewygodnego pomiaru z danych ani wybór „ładniejszej” korelacji do publikacji.
wariant = pary.drop(index=pary["drgania"].idxmax())
r_wariant = wariant["temperatura"].corr(wariant["drgania"])
print(len(pary), r_pelny, len(wariant), r_wariant)
r_grupy = pd.DataFrame([
    {"urzadzenie": u, "n": len(g),
     "r": g["temperatura"].corr(g["drgania"])}
    for u, g in pary.groupby("urzadzenie", observed=True)
])
display(r_grupy)
Wariant obejmuje 719 par i daje r ≈ 0,817, podczas gdy pełny zbiór daje około 0,644. W grupach urządzeń r wynosi w przybliżeniu od 0,102 do 0,778, przy n = 90. Różne poziomy analizy prowadzą do różnych opisów. Do końcowego W06 zachowujemy pełne dane i jawnie wskazujemy ograniczenia.
Mapa korelacji jako narzędzie diagnostyczne
Mapa ciepła pozwala przeglądać wiele par na raz. Dla korelacji używamy skali rozbieżnej o stałych granicach od −1 do 1 i neutralnym środku w zerze. Dzięki temu ten sam kolor nie oznacza innej wartości na każdej kolejnej mapie. Wartości liczbowe uzupełniają barwy.
miary = ["temperatura", "drgania", "energia", "produkcja"]
etykiety_miar = ["Temperatura", "Drgania", "Energia", "Produkcja"]
korelacje = df[miary].corr(method="pearson")
obecne = df[miary].notna().astype("int64")
n_par = obecne.T.dot(obecne)
display(korelacje.round(3))
display(n_par)

fig, ax = plt.subplots(figsize=(8, 5), layout="constrained")
obraz = ax.imshow(korelacje, cmap="BrBG", vmin=-1, vmax=1)
ax.set_xticks(range(4), etykiety_miar, rotation=25, ha="right")
ax.set_yticks(range(4), etykiety_miar)
for i in range(4):
    for j in range(4):
        wartosc = korelacje.iloc[i, j]
        ax.text(j, i, f"{wartosc:.3f}", ha="center", va="center",
                color="white" if abs(wartosc) > 0.75 else "black")
fig.colorbar(obraz, ax=ax, label="Korelacja Pearsona r")
ax.set_title("Korelacje pomagają wybrać pary do sprawdzenia")
zapisz(fig, "M4_macierz_korelacji.png")
Pandas oblicza korelację z dostępnych par dla każdej pary kolumn oddzielnie. Dlatego obok r potrzebujesz macierzy n. W temperaturze i drganiach jest 720 wspólnych wartości, lecz w energii i produkcji tylko 717. Usunięcie wszystkich wierszy z dowolnym brakiem przed obliczeniem całej macierzy byłoby inną strategią i wymagałoby uzasadnienia.
Jeżeli kolumna jest stała albo ma za mało dostępnych wartości, korelacja może być nieokreślona. Nie zamieniaj jej automatycznie na zero. W tym przykładzie wszystkie cztery wybrane miary są zmienne i pary mają wystarczającą liczebność do obliczenia współczynnika opisowego.
Sprawdź rozumienie 5
Czy r ≈ 0,644 pozwala stwierdzić, że temperatura powoduje drgania? Dlaczego trzeba sprawdzić wykres punktowy, pojedyncze urządzenia i liczbę dostępnych par, nawet gdy mapa korelacji wygląda przekonująco?
Od mapy do kolejnego pytania
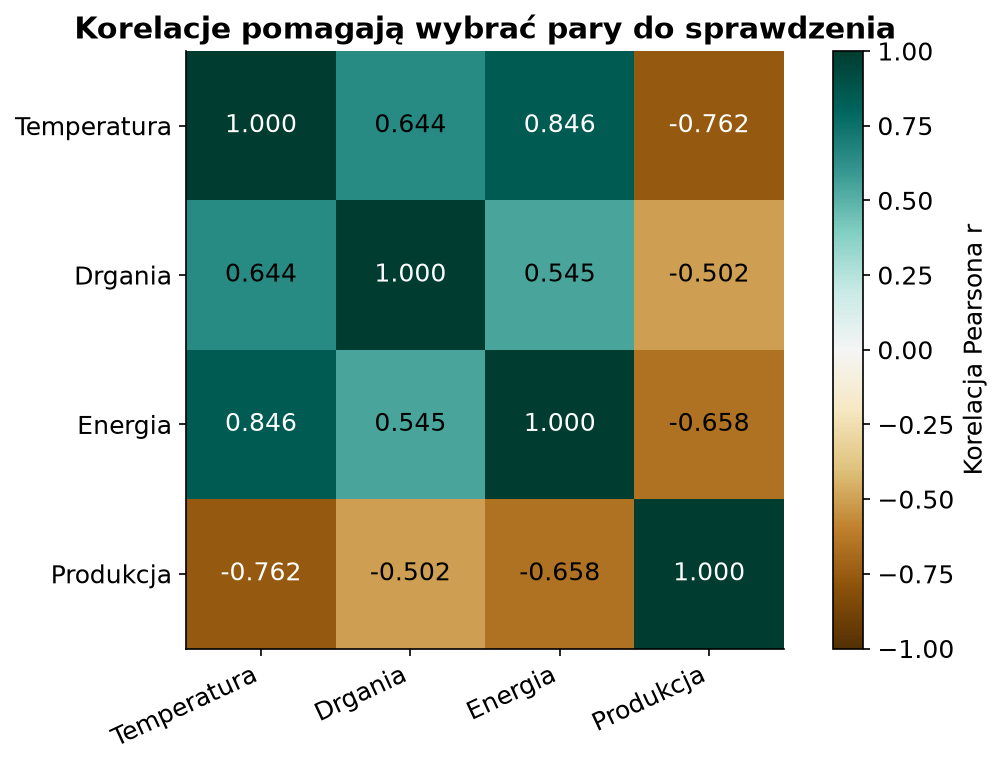
Rysunek 7. Diagnostyczna macierz korelacji Pearsona dla temperatury, drgań, energii i produkcji. Źródło: pomiary_clean.csv. Obliczenia parami, n od 717 do 720; wspólna skala −1 do 1. Wartości na przekątnej dotyczą korelacji zmiennej z samą sobą.
Liczebności różnią się między parami: temperatura i drgania mają n = 720; każda z nich z energią — 718, a z produkcją — 719. Energia i produkcja mają 717 kompletnych par. Wszystkie te wartości znajdziesz w macierzy n_par.
Wybierz jedną parę, na przykład energię i produkcję, i obejrzyj punkty. Kolor może oznaczać tryb pracy, ale wtedy potrzebna jest legenda i dodatkowy sposób rozróżnienia grup, na przykład kształt znacznika. Nie dodawaj kolejnych kanałów wizualnych, jeśli nie odpowiadają na pytanie.
W ćwiczeniu zapisz M4_C05_energia_produkcja.png. Sprawdź 717 par, opisz znak zależności i co najmniej jedno ograniczenie. Ujemna korelacja nie oznacza, że ograniczanie energii samo w sobie zwiększy produkcję.
8. Narracja dostępność i kontrola jakości
Wykres jest częścią komunikatu. Tytuł ustawia pytanie lub podaje główną obserwację, podpis wyjaśnia sposób obliczenia, a komentarz wskazuje znaczenie i ograniczenie. Te elementy powinny się uzupełniać. Odbiorca nie powinien potrzebować kodu, aby ustalić, co oznacza oś pionowa.
Od tytułu neutralnego do informacyjnego
„Mediana energii według hali i okresu” jest poprawnym tytułem neutralnym. „Hala A ma niższe mediany w obu okresach” eksponuje potwierdzoną obserwację. „Hala A jest najbardziej efektywna” dopisuje ocenę, której ta miara nie uzasadnia. Lepsza narracja nie oznacza odważniejszego twierdzenia, lecz precyzyjniejsze dopasowanie słów do wyniku.
Cztery warstwy opisu W03
|
Warstwa |
Przykład |
|---|---|
|
Tytuł |
Hala A ma niższe mediany w obu okresach |
|
Podpis |
Mediany energii przypisanej do pomiaru w kWh, według hali i okresu; styczeń pełny, luty 1–14; źródło M3-P05; liczebności podane przy rysunku 3 |
|
Obserwacja |
Dla Hali A mediany wynoszą 13,160 kWh w styczniu i 13,080 kWh w części lutego; w obu okresach są niższe niż dla B i C |
|
Ograniczenie |
Różne składy urządzeń i niepełny luty nie pozwalają na tej podstawie ocenić efektywności ani trwałego trendu |
Adnotacja służy skierowaniu uwagi na konkretny element, na przykład punkt 4,850 mm/s. Powinna wskazywać sprawdzony fakt. Napis „awaria czujnika” byłby diagnozą, a „wartość do sprawdzenia” odpowiada stanowi wiedzy w naszym projekcie.
Krótka narracja analityczna
Po pokazaniu obrazu zapisz dwa lub trzy zdania: co widzisz, na jakich danych opiera się obserwacja i czego nie rozstrzygasz. Liczby podawaj tylko wtedy, gdy pomagają zrozumieć wynik. Wszystkie liczby, nazwy grup i porównania muszą mieć wskazane miejsce w tabeli lub obliczeniu.
Przykład dla W06: „W 720 kompletnych parach temperatury i drgań obserwujemy dodatnią zależność liniową, r ≈ 0,644. Wynik obejmuje wiele urządzeń i zachowany pomiar 4,850 mm/s. Nie rozstrzyga kierunku przyczynowego ani przyczyny nietypowej wartości”.
Dostępność jest częścią poprawności
Odbiorca może czytać na małym ekranie, wydrukować książkę w szarości albo korzystać z czytnika ekranu. Sam kolor nie może być jedynym sposobem odróżnienia serii. Dodaj etykiety, różne style linii, kształty lub kreskowanie — zależnie od typu wykresu. Usuń dekoracje, które utrudniają odczyt danych.
Rozmiar czcionki oceniaj w docelowej wielkości obrazu, a nie po powiększeniu w notebooku. Sprawdź kontrast napisów, linię mediany, jasne serie i legendę. Przezroczystość użyteczna na ekranie może okazać się zbyt słaba po wydruku. Nie ściskaj wszystkich informacji do jednego małego panelu.
Tekst alternatywny
Tekst alternatywny opisuje istotny przekaz obrazu osobie, która go nie widzi. „Wykres słupkowy” to zbyt mało. Dla W01 możesz napisać: „Osiem urządzeń uszeregowanych według mediany drgań. U-05 ma najwyższą medianę 1,3735 mm/s, następne są U-08 i U-07. Każda mediana opiera się na 90 pomiarach; ranking nie ocenia stanu technicznego”.
Przechowuj opis w tabeli narracji, a podczas publikacji przypisz go do obrazu w edytorze dokumentu lub Moodle. Sam zapis pliku PNG nie gwarantuje przeniesienia tekstu alternatywnego do miejsca publikacji. Podpis widoczny pod rysunkiem i tekst alternatywny pełnią różne role, choć mogą częściowo powtarzać fakty.
Pięć obszarów kontroli
|
Obszar |
Pytanie przed publikacją |
|---|---|
|
Dane |
Czy wartości, pary, agregacja, liczebności i braki odpowiadają tabeli źródłowej? |
|
Obraz |
Czy zakresy, kolejność, jednostki i legenda są poprawne, a zbliżenia jawne? |
|
Narracja |
Czy każde twierdzenie ma oparcie w danych i zachowuje ograniczenia? |
|
Dostępność |
Czy przekaz działa bez koloru i przy docelowym rozmiarze, a obraz ma opis alternatywny? |
|
Eksport |
Czy zapisany plik otwiera się, ma właściwą nazwę i nie ucina podpisów ani etykiet? |
Udany zapis fig.savefig() potwierdza wykonanie operacji, nie gotowość publikacji. Otwórz wynikowy plik i sprawdź wszystkie pięć obszarów. Po istotnej zmianie danych lub kodu powtórz kontrolę.
Model językowy jako pomoc redakcyjna
LLM może zaproponować krótszy tytuł, poprawić czytelność podpisu lub wskazać zbyt mocne sformułowanie. Nie traktuj płynnej wypowiedzi jako dowodu. Podaj modelowi sprawdzone wyniki, zakres analizy i zakazane nadinterpretacje; udostępniaj wyłącznie dane, do których przekazania masz uprawnienia.
Przykładowe polecenie: „Na podstawie podanych median przygotuj neutralny tytuł, krótki podpis i dwa zdania obserwacji. Hala A: styczeń 13,160, luty 13,080; B: 14,790 i 14,695; C: 14,645 i 14,760 kWh na pomiar. Styczeń obejmuje 31 dni, luty dni 1–14. Nie oceniaj efektywności, nie podawaj przyczyn i nie formułuj prognoz. Zachowaj informację o niepełnym lutym”.
Weryfikacja zdanie po zdaniu
Jeśli odpowiedź brzmi „Hala A jest najbardziej efektywna i konsekwentnie poprawia wyniki”, rozdziel dwa twierdzenia. Pierwsze wymaga miary efektywności i porównywalnych warunków, których tu nie ma. Drugie sugeruje trwałą poprawę na podstawie zaledwie dwóch nierównych okresów. Oba wymagają korekty, mimo że liczby mogły zostać przepisane poprawnie.
Zapisz rzeczywisty prompt, odpowiedź, kontrolę, werdykt i uzasadnienie w docs/rejestr_uzycia_LLM.csv, w polu modul podając M4. Rozróżniaj: przyjęto, poprawiono i odrzucono. Nie zapisuj przykładowej rozmowy z książki jako własnej wykonanej konsultacji. Jeśli pracujesz offline bez modelu, wykonaj ten sam audyt samodzielnie; użycie LLM nie jest warunkiem ukończenia lektury.
Ćwiczenie audytorskie
Wyobraź sobie W03 z osią zaczynającą się od 12 kWh, sześcioma przypadkowymi kolorami, bez jednostki, liczebności i dat, zatytułowany „Hala A wygrywa dzięki oszczędnościom”. Wskaż co najmniej pięć problemów. Rozdziel błąd danych, błąd obrazu i nieuzasadnioną interpretację. Nie nazywaj każdej wady „złym kolorem”.
W notebooku możesz zachować celowo wadliwy wariant jako M4_C06_przed.png, wyraźnie oznaczony jako ćwiczenie. Poprawioną wersję W03 zapisz pod nazwą końcową. Porównaj oba obrazy i zanotuj, co dokładnie naprawia każda zmiana.
Sprawdź rozumienie 6
LLM poprawnie przepisał sześć median, ale nazwał halę o niższej medianie energii „najbardziej efektywną”. Czy możesz przyjąć ten opis? Co zachowasz, co poprawisz i jak udokumentujesz decyzję?
Tabela narracji łączy obraz z dowodem
Sześć końcowych plików powinno mieć sześć odpowiadających im wierszy opisu. Poniższy kod tworzy szkielet tabeli przy pierwszym uruchomieniu. Jeśli tabela już istnieje, odczytuje ją, aby ponowny start notebooka nie usuwał Twoich opisów i decyzji.
nazwy = [
    "M4_W01_ranking_drgan.png", "M4_W02_energia_dzien.png",
    "M4_W03_energia_okres_lokalizacja.png",
    "M4_W04_histogram_drgania.png",
    "M4_W05_boxplot_drgania_urzadzenie.png",
    "M4_W06_temperatura_drgania.png"
]
powiazania = ["M3-P03", "M3-P05 rozwinięcie dzienne", "M3-P05",
               "M3-P01", "M3-P01 i M3-P03", "M3-P06"]
pola = ["id_wykresu", "id_pytania", "wynik_zrodlowy", "plik",
        "tytul", "podpis", "obserwacja", "ograniczenie",
        "tekst_alternatywny", "status_qc"]
plik_narracji = TABLES / "M4_tabela_narracji.csv"
if not plik_narracji.exists():
    wiersze = []
    for i, nazwa in enumerate(nazwy):
        wiersz = dict.fromkeys(pola, "")
        wiersz.update(
            id_wykresu=f"M4-W{i + 1:02d}",
            id_pytania=powiazania[i],
            plik=f"outputs/figures/{nazwa}",
            status_qc="NIE_SPRAWDZONO"
        )
        wiersze.append(wiersz)
    pd.DataFrame(wiersze, columns=pola).to_csv(
        plik_narracji, index=False, encoding="utf-8"
    )
narracja = pd.read_csv(plik_narracji, dtype="string",
                       keep_default_na=False)
assert narracja.columns.tolist() == pola
assert narracja["id_wykresu"].is_unique and len(narracja) == 6
display(narracja)
Uzupełnij pola własnymi sprawdzonymi opisami. Wynik_zrodlowy ma wskazywać plik lub konkretne obliczenie, nie ogólne „dane”. W polu plik zachowaj ścieżkę względem projektu. Po edycji ramki zapisz ją przez narracja.to_csv(plik_narracji, index=False, encoding="utf-8").
Statusy oznaczają: NIE_SPRAWDZONO — brak audytu, DO_POPRAWY — wykryty problem, GOTOWY — zakończona kontrola pięciu obszarów. Kod nie przyznaje ostatniego statusu automatycznie. Gdy wykres zmieni się po kontroli, zaktualizuj opis i ponownie oceń gotowość.
9. Powtarzalny workflow modułu 4
Rezultatem modułu jest spójny zestaw wykresów z udokumentowanym pochodzeniem i opisami, nie sam katalog atrakcyjnych obrazów. Poniższa kolejność łączy wszystkie rozdziały w proces, który możesz powtórzyć na własnych danych.
|
Etap |
Wynik potwierdzający wykonanie |
|---|---|
|
Przygotuj wejście |
Właściwy pomiary_clean.csv, odtworzone typy i kontrole zakresu danych |
|
Zapisz mapę pytań |
W01–W06 powiązane z pytaniem i wynikiem źródłowym |
|
Przygotuj tabele |
Ranking, 45 dni energii, okresy i hale, grupy oraz kompletne pary |
|
Zbuduj i sprawdź obrazy |
Sześć wykresów oraz diagnostyczna mapa, wartości zgodne z tabelami |
|
Napisz opisy |
Tytuły, podpisy, obserwacje, ograniczenia i teksty alternatywne |
|
Wykonaj audyt |
Pięć obszarów kontroli oraz rzeczywiste statusy w tabeli narracji |
|
Odtwórz pracę |
Restart kernel i uruchomienie wszystkich komórek od góry, następnie kontrola zapisanych plików |
Końcowa kontrola techniczna
assert all((FIGURES / nazwa).is_file() for nazwa in nazwy)
assert sha256(plik.read_bytes()).hexdigest() == hash_wejscia
ponownie = pd.read_csv(TABLES / "M4_energia_dzien.csv",
                       parse_dates=["dzien"])
pd.testing.assert_frame_equal(
    energia_dzien, ponownie, check_dtype=False,
    check_exact=False, rtol=1e-12, atol=1e-12
)
assert set(narracja["status_qc"]) <= {
    "NIE_SPRAWDZONO", "DO_POPRAWY", "GOTOWY"
}
print(narracja["status_qc"].value_counts())
Ta kontrola nie zastępuje oglądania PNG ani sprawdzenia opisów. Tolerancja numeryczna uwzględnia zapis i odczyt liczb; nie ma ukrywać merytorycznych różnic. Zgodny hash potwierdza niezmienność pliku wejściowego, nie jego jakość.
Gdy coś nie działa
Przy FileNotFoundError sprawdź katalog roboczy i pełną nazwę pliku. Przy błędzie pivot sprawdź unikalność pary okres i lokalizacja oraz format eksportu. Przy brakujących podpisach obejrzyj zapis z bbox_inches="tight" i rozmiar figury. Przy rozbieżności liczb porównaj agregację, filtr braków i poziom grupowania. Nie rozwiązuj tych problemów ręczną korektą obrazka.
10. Odpowiedzi do samooceny
Pytania z sześciu rozdziałów
1. Identyfikatory urządzeń są kategoriami, nie ciągłą skalą. Lepsze są poziome słupki na wspólnej osi, uporządkowane według mediany. Każdy słupek oznacza medianę dostępnych pomiarów jednego urządzenia, a nie pojedynczy pomiar ani sumę drgań.
2. Wartość na wykresie słupkowym jest kodowana długością od podstawy. Ucięcie początku osi zniekształca proporcje długości i może wyolbrzymić różnice. Równość po zaokrągleniu nie oznacza równości obliczonych median; sortowanie powinno używać pełnych wartości.
3. Pas Q1–Q3 opisuje środkowe około 50% wartości w danym dniu, nie przedział ufności mediany. W03 porównuje różne zakresy obserwacji: 31 dni stycznia i 14 dni lutego. Mediany nie rosną mechanicznie wraz z liczbą dni, ale mogą zależeć od tego, które dni uwzględniono.
4. Przy regule 1,5 × IQR wąsy kończą się na obserwacjach mieszczących się w jej granicach. Minimum lub maksimum może być pokazane osobnym punktem. Granice dla wszystkich urządzeń i dla U-01 są inne; 0,781 i 0,786 mm/s mogą być nietypowe globalnie, lecz mieścić się w lokalnym profilu U-01.
5. Korelacja nie wskazuje przyczyny. Wykres punktowy ujawnia kształt i punkty wpływające na wynik, analiza urządzeń — zróżnicowanie grup, a n — rzeczywistą podstawę obliczenia. Zbiór miesza urządzenia i ich powtarzane pomiary. Globalne r nie opisuje automatycznie każdego urządzenia.
6. Poprawne przepisanie liczb nie uzasadnia oceny efektywności. Zachowaj potwierdzone mediany i relację „niższa”, usuń lub popraw ocenę „najbardziej efektywna”. W rejestrze LLM zapisz kontrolę tabeli, nieuzasadnione twierdzenie, poprawioną wersję i werdykt „poprawiono”.
Wskazówki do ćwiczeń
W02 zawiera 45 punktów reprezentujących dni; W03 sześć słupków reprezentujących trzy hale w dwóch okresach. Obie agregacje tracą informację o pojedynczych rekordach. W ćwiczeniu produkcji otrzymasz 45 dni, 719 dostępnych wartości i n = 15 w dniu 2 lutego; w pozostałych dniach n = 16. Dzienne mediany mieszczą się w przedziale 146–160 sztuk na rekord.
W histogramie temperatury różna liczba przedziałów zmienia szczegóły kształtu, ale suma liczebności pozostaje 720. Dla energii i produkcji oczekujesz 717 par i r ≈ −0,658. W audycie W03 popraw między innymi podstawę słupków, jednostkę, legendę, zakres dat, liczebności oraz nieuzasadniony tytuł przyczynowy.
11. Słownik pojęć
|
Pojęcie |
Znaczenie w module |
|---|---|
|
Zadanie wizualne |
Rodzaj odpowiedzi, której szukasz w obrazie, na przykład porównanie lub rozkład |
|
Agregacja |
Zastąpienie wielu obserwacji podsumowaniem dla grupy, takim jak mediana dnia |
|
Figure |
Cała figura Matplotlib, mogąca zawierać kilka obszarów wykresów |
|
Axes i Axis |
Axes jest obszarem wykresu, Axis odpowiada za pojedynczą oś i jej podziałkę |
|
Mediana |
Środkowe położenie uporządkowanych danych, odmienne od sumy i średniej |
|
Q1 i Q3 |
Kwartyle wyznaczające środkową część rozkładu; nie przedział ufności |
|
IQR |
Rozstęp międzykwartylowy Q3 − Q1, miara rozrzutu środkowej części danych |
|
Przedział histogramu |
Zakres wartości, dla którego zliczana jest liczba obserwacji |
|
Wąsy pudełka |
Skrajne obserwacje mieszczące się w wybranej regule; tutaj 1,5 × IQR |
|
Kompletna para |
Dwie istniejące wartości z tego samego rekordu, użyte do zależności |
|
Korelacja Pearsona |
Miara kierunku i siły zależności liniowej; nie dowód przyczynowości |
|
Skala rozbieżna |
Skala barw z neutralnym środkiem, tu dla wartości ujemnych i dodatnich r |
|
Adnotacja |
Krótki napis wskazujący określony element obrazu |
|
Tekst alternatywny |
Opis znaczenia obrazu dla osoby, która go nie widzi |
|
DPI |
Liczba pikseli na cal podczas zapisu obrazu rastrowego |
|
QC |
Kontrola jakości danych, obrazu, narracji, dostępności i eksportu |
Najważniejsza zasada
Wynik źródłowy, wykres i opis muszą mówić o tym samym. Jeśli zmienisz filtr, agregację, zakres lub źródło, sprawdź wszystkie trzy elementy. Dobrze przygotowany materiał pokazuje nie tylko to, co wiadomo, ale także granicę tego, czego jeszcze nie rozstrzygnięto.
12. Wykaz plików i materiałów modułu
Sześć wykresów końcowych
Wszystkie poniższe obrazy zapisujesz w outputs/figures. Nazwy są zgodne z kartą pracy modułu 4. W01–W06 identyfikują rezultaty końcowe; pliki C03–C06 służą odrębnym ćwiczeniom.
|
Plik |
Zawartość |
|---|---|
|
M4_W01_ranking_drgan.png |
Ranking median drgań urządzeń |
|
M4_W02_energia_dzien.png |
Dzienne mediany energii i Q1–Q3 |
|
M4_W03_energia_okres_lokalizacja.png |
Mediany energii według hali i okresu |
|
M4_W04_histogram_drgania.png |
Rozkład drgań, pełny zakres i zbliżenie |
|
M4_W05_boxplot_drgania_urzadzenie.png |
Rozkłady drgań według urządzenia |
|
M4_W06_temperatura_drgania.png |
Kompletne pary temperatury i drgań |
|
M4_macierz_korelacji.png |
Dodatkowa mapa diagnostyczna |
Tabele i notebook
|
Plik w outputs/tables |
Rola |
|---|---|
|
M3_P05_energia_miesiac_lokalizacja.csv |
Wejście z M3 w formacie wierszowym; bez nadpisywania |
|
M4_energia_dzien.csv |
45 wierszy i pola dzien n mediana q1 q3 |
|
M4_drgania_urzadzenie_podsumowanie.csv |
Osiem urządzeń, n oraz mediana drgań |
|
M4_tabela_narracji.csv |
Sześć wierszy opisów z pochodzeniem i statusem kontroli |
Kod i komentarze przechowuj w notebooks/M4_wizualizacja.ipynb. W README.md zapisz wersje środowiska, plik wejściowy oraz kolejność odtworzenia. Zachowaj słownik danych i, jeśli rzeczywiście korzystasz z modelu językowego, rejestr użycia LLM.
Podstawa opracowania
Podstawą jest prezentacja M4-v2.pptx „Wizualizacja danych i narracja analityczna”. Przykłady i rysunki korzystają z danych kursowych po przygotowaniu w M2 oraz wyników M3. Nazwy są zgodne z kartą M4_Instrukcja_wizualizacja.docx.