Podręcznik uczestnika z objaśnieniami, przykładami i ćwiczeniami do samodzielnej nauki
| Site: | SEZAM - System Edukacyjnych Zasobów Akademickich i Multimedialnych |
| Course: | Python, LLM i analiza danych w notatnikach Jupyter |
| Book: | Podręcznik uczestnika z objaśnieniami, przykładami i ćwiczeniami do samodzielnej nauki |
| Printed by: | Gość |
| Date: | Wednesday, 18 November 2026, 10:39 PM |
Table of contents
- 1. Jak korzystać z podręcznika
- 2. Projekt i dane modułu 5
- 3. Rola ograniczenia i bezpieczeństwo LLM
- 4. Prompt analityczny jako specyfikacja zadania
- 5. Kod wyjaśnianie debugowanie i refaktoryzacja
- 6. Wsparcie analizy wykresów i raportu
- 7. Protokół weryfikacji odpowiedzi LLM
- 8. Rejestr użycia LLM i ocena wartości
- 9. Pełny workflow i zakończenie modułu
- 10. Gotowość do modułu 6
- 11. Podsumowanie i odpowiedzi do samooceny
- 12. Słownik pojęć
1. Jak korzystać z podręcznika
W module 5 uczysz się korzystać z dużego modelu językowego, czyli LLM, podczas analizy danych. Model może pomóc napisać kod, dostrzec pytanie lub uporządkować opis. Poprawność wyniku musisz jednak samodzielnie uzasadnić: odpowiedzialność za dane, obliczenia i wniosek pozostaje po Twojej stronie.
Podręcznik zawiera objaśnienia, prompty, analizę przykładowych odpowiedzi, wyniki kontrolne i pytania z odpowiedziami na końcu. Możesz czytać go offline, bez oglądania slajdów. Odtworzenie obliczeń wymaga lokalnego notebooka i danych z poprzednich modułów, lecz nie połączenia z LLM.
Odpowiedzi oznaczone jako dydaktyczne służą do ćwiczenia oceny; nie są zapisem rzeczywistej rozmowy. Pracując z modelem, zachowuj jego faktyczne odpowiedzi. W wariancie offline zapisuj „analiza przykładu dydaktycznego”, bez wymyślania nazwy modelu, daty rozmowy czy historii użycia.
Sposób pracy
Czytaj kolejno przy pierwszym przejściu. Przy ćwiczeniach wracaj do kryteriów akceptacji i przykładów testów. Kod wykonywalny uruchamiaj od początku w notebooku M5; blok opisany jako błędna propozycja służy do analizy, nie do bezpośredniego włączenia do rozwiązania. Pytania „Sprawdź rozumienie” pozwalają zatrzymać się i sformułować własną odpowiedź przed zajrzeniem do podsumowania.
2. Projekt i dane modułu 5
Kontynuujesz projekt analizy pomiarów eksploatacyjnych. Moduł 2 przygotował dane, moduł 3 uporządkował pytania i obliczenia, a moduł 4 połączył wykresy z ostrożną narracją. W module 5 sprawdzasz, gdzie LLM rzeczywiście wspiera ten proces i jak nie dopuścić, aby niezweryfikowana sugestia zmieniła znaczenie analizy.
Pracujesz na data/processed/pomiary_clean.csv. To wynik wcześniejszego przygotowania danych, a nie nowy surowy plik. Zawiera 720 rekordów i 14 kolumn, osiem urządzeń U-01–U-08 oraz po 90 obserwacji urządzenia. Zakres obejmuje 1 stycznia–14 lutego 2026 roku. Temperatura i drgania są kompletne; energia ma dwa braki, produkcja jeden. Pomiar drgań 4,850 mm/s pozostaje w danych jako przypadek do wyjaśnienia, a nie potwierdzony błąd.
Plik |
Rola w projekcie |
|---|---|
notebooks/M5_praca_z_LLM.ipynb |
Kod, prompty, testy, decyzje i szczegółowe wpisy o użyciu LLM |
data/processed/pomiary_clean.csv |
Niezmieniane wejście do obliczeń modułu |
docs/slownik_danych.md |
Znaczenie pól i jednostek oraz wcześniejsze decyzje |
docs/rejestr_uzycia_LLM.csv |
Wspólny, siedmiokolumnowy indeks użycia LLM |
outputs/figures/M4_W06_temperatura_drgania.png |
Wykres z M4 rozwijany w analizie korelacji |
outputs/tables/M4_tabela_narracji.csv |
Wcześniejsze opisy i ograniczenia wykresów |
Ścieżki odnoszą się do Twojego projektu, nie do katalogów dystrybucyjnych pakietu kursowego. Jeśli nie masz przygotowanego CSV, wróć do wyniku modułu 2. Nie twórz pliku o tej samej nazwie z przypadkowymi danymi i nie zmieniaj testów tylko po to, by zaakceptowały inne wejście.
Jedna historia zamiast wielu niepowiązanych rozmów
W kolejnych rozdziałach wracają trzy przypadki: M5-U01 to naprawa rankingu median drgań, M5-U02 to korelacja temperatury i drgań w urządzeniach, a M5-U03 to porównanie trybów pracy. Prompt M5-P01 dotyczy debugowania, M5-P02 — dwóch kierunków analizy. Wpisy M5-L01–M5-L03 dokumentują decyzje w tych przypadkach. Odróżniaj identyfikator zadania M5-U01 od identyfikatora urządzenia U-01.
3. Rola ograniczenia i bezpieczeństwo LLM
LLM tworzy odpowiedź na podstawie dostępnego mu kontekstu. Sprawny język nie potwierdza, że model zna Twój zbiór, uruchomił kod lub sprawdził wynik. Zdanie „analiza wykazała” może być jedynie wiarygodnie brzmiącym tekstem. Najpierw zapytaj więc: „skąd pochodzi to twierdzenie?”.
Co model faktycznie otrzymał
Kontekst może obejmować polecenie, kod, błąd, schemat, tabelę, załącznik lub wynik narzędzia. Jego zakres zależy od środowiska i rzeczywiście przekazanych materiałów. Nazwa pomiary_clean.csv nie przekazuje zawartości pliku, a nazwa df nie daje dostępu do pamięci kernela Jupyter.
Rozróżniaj trzy sytuacje: model proponuje kod bez danych, interpretuje podane mu wyniki albo korzysta z narzędzia, które rzeczywiście coś obliczyło. W pierwszej sytuacji nie ma podstaw do podawania konkretnych median. W drugiej może opisać udostępnioną tabelę, ale nie powinien dopisywać niewidocznych zależności. W trzeciej nadal potrzebujesz informacji o wejściu, wykonanej operacji i rezultacie narzędzia.
W praktyce pomocne jest zdanie otwierające prompt: „Nie masz dostępu do mojego pliku ani kernela. Otrzymujesz wyłącznie schemat i kod poniżej”. Nie stanowi ono gwarancji prawidłowej odpowiedzi, lecz jasno wyznacza granicę zadania. Po odpowiedzi sprawdź, czy model tej granicy nie przekroczył.
Trzy typowe błędy
|
Rodzaj błędu |
Przykład |
Właściwa kontrola |
|---|---|---|
|
Wymyślony schemat |
Użycie drgania_mm_s zamiast istniejącego drgania |
Porównanie z df.columns i słownikiem |
|
Wymyślona operacja |
Wywołanie nieistniejącej metody biblioteki |
Sprawdzenie dostępnej funkcji i mały test w środowisku |
|
Wymyślony wynik |
Podanie korelacji bez danych ani wyniku obliczeń |
Samodzielne obliczenie na określonych parach |
Nawet kod, który się wykonuje, może być niepoprawny dla pytania. Jeśli prosisz o medianę energii według typu urządzenia, a odpowiedź liczy średnią po globalnym usunięciu braków, otrzymujesz odpowiedź na inne pytanie. Brak wyjątku potwierdza tylko możliwość wykonania programu, nie zgodność metody z Twoim celem.
Dobieranie zadania do ryzyka
Dobrym pierwszym zastosowaniem jest zadanie wąskie, odwracalne i łatwe do sprawdzenia. Wyjaśnienie komunikatu błędu albo przygotowanie szkicu testu zwykle pozwala ograniczyć kontekst do schematu i krótkiego fragmentu kodu. Znacznie większej ostrożności wymagają zmiany danych, dobór metody statystycznej i interpretacja przyczyn.
|
Klasa zastosowania |
Przykład w kursie |
Warunek decyzji |
|---|---|---|
|
Odpowiednie |
Wyjaśnienie KeyError; szkic opisu zweryfikowanego wykresu |
Potrafisz sprawdzić rezultat i ograniczyć kontekst |
|
Ryzykowne |
Propozycja agregacji, czyszczenia lub hipotezy |
Weryfikujesz założenia, skutki i granice wniosku |
|
Niedopuszczalne w danym zadaniu |
Przekazanie nieuprawnionych danych; automatyczna decyzja o wyłączeniu urządzenia |
Nie wykonujesz działania; zmieniasz zakres zadania |
Klasa opisuje zastosowanie w określonych warunkach, a nie stałą ocenę modelu. Pomysł na agregację może być użyteczny jako propozycja do sprawdzenia, a niedopuszczalny jako automatyczna ingerencja w dane bez kontroli. Koszt pomyłki i możliwość jej wykrycia są ważniejsze niż długość odpowiedzi.
Minimalny kontekst i bezpieczne środowisko
Przekazuj najpierw cel i schemat, następnie tylko potrzebny kod albo zweryfikowane agregaty. Jeżeli do odtworzenia błędu potrzebne są wartości, rozważ mały przykład syntetyczny, jednoznacznie oznaczony jako wymyślony do testu. Pełne rekordy są ostatnim, a nie domyślnym poziomem kontekstu. Usunięcie imienia czy nazwy firmy nie musi wystarczyć: kombinacja dat, lokalizacji i identyfikatorów także może ujawniać informacje.
Przed pracą sprawdź, czy wybrane środowisko i zakres danych są dopuszczone w Twojej organizacji. Uwzględnij uprawnienia, historię rozmów, logi, załączniki i ewentualne narzędzia z dostępem do plików. Model uruchamiany lokalnie nie oznacza automatycznie braku połączeń zewnętrznych; usługa zdalna nie zwalnia z oceny ustawień i zasad przetwarzania. W razie braku pewności pozostań przy schemacie i danych syntetycznych.
Nie przekazuj haseł, kluczy dostępu, danych osobowych ani poufnych materiałów bez właściwej podstawy i zgody na taki sposób użycia. Nie uruchamiaj bez przeglądu kodu kasującego pliki, pobierającego zawartość z sieci lub instalującego dodatkowe pakiety. W tym module wystarcza kontrolowane środowisko analityczne i lokalne dane kursowe.
Mapa zastosowań przed pierwszym promptem
Mapa pomaga zdecydować, czego w ogóle nie przekazywać modelowi. Zapisz dla zadania: cel, oczekiwany rezultat, klasę ryzyka, minimalny kontekst, środowisko, sposób sprawdzenia i decyzję. Taka kolejność ogranicza pokusę wysłania całego notebooka, zanim ustalisz, czego potrzebujesz.
|
Zadanie |
Ocena w module |
Uzasadnienie i kontrola |
|---|---|---|
|
M5-U01 Naprawa KeyError |
Odpowiednie |
Schemat i kod wystarczą; test rankingu i niezmienności df |
|
M5-U02 Korelacje w urządzeniach |
Ryzykowne |
Pomysł wymaga kontroli par, grup, wykresów i języka wniosku |
|
M5-U03 Porównanie trybów |
Ryzykowne |
Nazwa trybu nie dowodzi efektu; porównanie rozkładów i grup |
|
M5-U04 Opis wykresu |
Odpowiednie warunkowo |
Udostępniasz sprawdzone wyniki i ograniczenia; kontrolujesz każde zdanie |
|
M5-U05 Dane pracowników |
Niedopuszczalne bez uprawnienia |
Wysyłanie danych do niezatwierdzonej usługi wykracza poza ćwiczenie |
|
M5-U06 Wyłączenie urządzenia |
Niedopuszczalne jako decyzja LLM |
Brak dowodów diagnostycznych i uprawnienia do działania |
To przykład mapy dla tego projektu, nie uniwersalna lista zakazów dla wszystkich analiz. Dla własnego zadania zmienią się kontekst, koszt błędu i warunki dopuszczenia. Zachowaj przynajmniej jeden przypadek odrzucony: umiejętność niewykorzystania LLM tam, gdzie nie jest potrzebny lub bezpieczny, jest częścią kompetencji analityka.
Oczekiwany efekt pracy
Po tym rozdziale umiesz wskazać jeden wybrany przypadek, podać jego minimalny kontekst i zaplanować kontrolę wyniku. Dla M5-U01 będzie to błąd nazwy kolumny w rankingu median drgań. Model nie potrzebuje ani pełnego CSV, ani kartoteki urządzeń, żeby zasugerować poprawkę. Do stwierdzenia, że poprawka działa na danych, potrzebny jest już Twój notebook.
Sprawdź rozumienie 1
W promptcie podano nazwę pliku i prośbę o ranking. Model zwrócił osiem urządzeń z dokładnymi medianami, ale nie otrzymał danych i nie użył narzędzia do ich odczytu. Co możesz potraktować jako propozycję, a czego nie możesz uznać za wynik analizy? Jak zmniejszyć kontekst, jeśli chcesz jedynie naprawić nazwę kolumny?
4. Prompt analityczny jako specyfikacja zadania
Dobry prompt opisuje pracę w sposób, który pozwala później rozstrzygnąć, czy została wykonana poprawnie. Nie chodzi o znalezienie magicznego zwrotu, lecz o usunięcie niejednoznaczności: co liczyć, na jakim schemacie, czego nie zmieniać i po czym poznać sukces. Prompt przypomina krótką specyfikację zadania, którą może przeczytać także inny analityk.
Sześć elementów dobrego polecenia
|
Element |
Pytanie pomocnicze |
Przykład dla M5-U01 |
|---|---|---|
|
Cel |
Co ma powstać lub zostać naprawione? |
Ranking median drgań po naprawie KeyError |
|
Kontekst |
W jakiej sytuacji pracujesz? |
Lokalny notebook, ramka df, kod Pandas |
|
Schemat lub wyniki |
Co model rzeczywiście wie? |
Istnieją urzadzenie i drgania; jednostka mm/s |
|
Ograniczenia |
Czego nie wolno zmienić? |
Bez zmiany mediany na średnią i bez modyfikacji df |
|
Format odpowiedzi |
Jak ma wyglądać rezultat? |
Przyczyna, minimalny kod, testy, ograniczenia |
|
Kryteria akceptacji |
Co sprawdzisz? |
Poprawna kolumna, osiem grup, sortowanie, brak zmian wejścia |
W rolę kontekstu nie wchodzi wszystko, co wiesz o projekcie. Wchodzi to, co jest potrzebne do wykonania wybranego zadania. Rozbudowany opis instalacji urządzeń nie pomoże naprawić literówki, a może rozproszyć uwagę i niepotrzebnie ujawnić dane. Z kolei pominięcie słowa „mediana” pozostawia otwartą decyzję, której model nie powinien podejmować za Ciebie.
Wersja zbyt ogólna
Prompt M5-P01 v0 brzmi: „Napraw KeyError w moim rankingu drgań. Daj działający kod”. Nawet jeśli dołączysz błędny fragment, bez schematu model nie wie, czy należy zmienić nazwę w kodzie, wczytać inną kolumnę, czy poprawić dane. Bez ograniczeń może również zaproponować rozwiązanie, które niepostrzeżenie zmienia miarę lub ramkę wejściową.
Nie oceniaj takiego promptu tylko po tym, czy odpowiedź jest długa i uprzejma. Zapytaj, ile istotnych decyzji pozostawiłeś nieokreślonych. Uzupełnienie polecenia powinno wynikać z rozpoznanej luki, a nie z przypadkowego dopisywania poleceń typu „bądź dokładny”. Dokładność staje się sprawdzalna dopiero wtedy, gdy określisz oczekiwania.
Pełny przykład promptu M5 P01
Poniższy prompt v1 możesz wykorzystać jako wzór. Nazwy kolumn zapisuj dokładnie tak, jak występują w danych. Jednostka w opisie nie jest częścią nazwy pola.
„Pracuję w Jupyter Notebook z Pandas. Nie masz dostępu do mojego pliku ani kernela. Chcę naprawić KeyError w kodzie poniżej i otrzymać medianę drgań dla każdego urządzenia, posortowaną malejąco. Ramka df ma kolumny urzadzenie i drgania; drgania są liczbami w mm/s. Kolumna drgania_mm_s nie istnieje. Identyfikatory i drgania są kompletne. Dane kursowe mają 720 wierszy, osiem urządzeń i po 90 pomiarów urządzenia.
Nie zmieniaj nazw kolumn w df, nie dodawaj aliasu, nie usuwaj rekordów i nie uzupełniaj braków. Zachowaj medianę oraz grupowanie po urzadzenie. Użyj wyłącznie Pandas. Zwróć krótkie wyjaśnienie przyczyny, minimalnie poprawiony kod, propozycję testów i informację, czego nie możesz zweryfikować bez danych. Nie podawaj liczbowych median, których nie obliczyłeś.
Kryteria akceptacji: istniejąca kolumna drgania, osiem grup, sortowanie malejące, niezmieniona ramka df. Test wartości wykonam niezależnie w swoim notebooku”.
Kod dołączony do polecenia jest celowo błędny:
ranking = (
    df.groupby("urzadzenie")["drgania_mm_s"]
    .median().sort_values(ascending=False)
)
Dwie przygotowane odpowiedzi do analizy offline
Odpowiedź A jest przykładem dydaktycznym niepoprawnej „naprawy”. Usuwa błąd nazwy, ale ingeruje w wejście i zmienia miarę. Nie uruchamiaj jej na głównej ramce.
df.rename(columns={"drgania": "drgania_mm_s"}, inplace=True)
ranking = (
    df.groupby("urzadzenie")["drgania_mm_s"]
    .mean().sort_values(ascending=False)
)
Odpowiedź B, również dydaktyczna, brzmi: „Kod odwołuje się do nieistniejącej kolumny. Zastąp drgania_mm_s przez drgania, zachowując medianę i sortowanie. Bez danych nie potwierdzę wartości rankingu ani liczby grup; uruchom testy lokalnie”. Kierunek poprawki jest zgodny ze specyfikacją. Dopiero rozdział 3 dostarczy dowodów, czy jego wykonanie spełnia kryteria na Twoim wejściu.
Porównywanie wersji promptu
Jeśli korzystasz z modelu, porównaj v0 i v1 na tym samym problemie i w tych samych warunkach. Zachowaj nazwę modelu, dostępne ustawienia, zakres kontekstu i pełne odpowiedzi. Użyj oddzielnych nowych rozmów, aby odpowiedź na v1 nie korzystała ukrycie z wyjaśnień przekazanych w rozmowie o v0. Nie wybieraj wyłącznie najkorzystniejszej odpowiedzi z wielu prób.
Jedna odpowiedź dla każdej wersji jest ćwiczeniem jakościowym, a nie rzetelnym rankingiem modeli czy dowodem statystycznym przewagi promptu. Możesz stwierdzić, że w obserwowanej próbie v1 lepiej zachował miarę i ograniczenia. Nie możesz na tej podstawie twierdzić, że zawsze będzie bezbłędny.
|
Kryterium |
Odpowiedź A |
Odpowiedź B |
|---|---|---|
|
Zgodność z nazwą pola |
Tworzy nową nazwę przez zmianę df |
Wskazuje istniejące drgania |
|
Zachowanie miary |
Zmienia medianę na średnią |
Zachowuje medianę |
|
Niezmienność wejścia |
Naruszona przez inplace=True |
Poprawka może działać bez zmiany df |
|
Uczciwość wobec braku danych |
Sam kod nie dostarcza wyników testów |
Jawnie wskazuje potrzebę lokalnej kontroli |
|
Decyzja przed testami |
Odrzucić jako rozwiązanie zadania |
Dopuścić do sprawdzenia, nie zatwierdzać z góry |
Iteracja oparta na przyczynie
Wersję v2 twórz po rozpoznaniu konkretnej niezgodności. Jeśli odpowiedź poprawiła nazwę, ale nie określiła formatu wyniku, dopisz kontrakt tabeli. Jeśli zabrakło testu niezmienności, zażądaj pełnego porównania ramki przed i po. Zachowaj v1 wraz z powodem zmiany, żeby później było wiadomo, co rzeczywiście poprawiono.
W rozdziale 3 świadomie rozszerzymy wynik: zamiast samej serii median powstanie tabela z identyfikatorem, medianą i liczebnością n. To zmiana specyfikacji wyniku, a nie efekt uboczny naprawy literówki. Rozdzielaj takie decyzje także w dokumentacji.
Sprawdź rozumienie 2
Model usunął wyjątek, lecz zastąpił medianę średnią i zmienił nazwę kolumny w df. Czy możesz uznać zadanie za wykonane? Wskaż dwa kryteria, które pozwalają odrzucić odpowiedź bez oceniania jej stylu. Co zapiszesz w porównaniu v0 i v1, jeżeli pracujesz wyłącznie offline?
5. Kod wyjaśnianie debugowanie i refaktoryzacja
LLM może wyjaśniać istniejący kod, proponować nowy, pomagać w debugowaniu i porządkować rozwiązanie. Każda z tych czynności ma inny punkt odniesienia. Przy wyjaśnianiu sprawdzasz zgodność opisu z operacjami. Przy generowaniu — zgodność kodu ze specyfikacją. Przy debugowaniu — usunięcie przyczyny błędu bez niezamierzonej zmiany sensu. Przy refaktoryzacji — zachowanie uzgodnionego zachowania programu.
Przygotowanie niezależnej sesji
Notebook zapisz jako notebooks/M5_praca_z_LLM.ipynb. Poniższy blok obsługuje uruchomienie z głównego katalogu projektu albo z notebooks. Jeśli używasz innego katalogu roboczego, wskaż PROJECT_DIR jawnie. Blok nie pobiera danych ani nie łączy się z modelem. Zapisuje informacje potrzebne do odtworzenia obliczeń.
from pathlib import Path
from hashlib import sha256
import sys
import pandas as pd
import numpy as np

PROJECT_DIR = Path.cwd()
if PROJECT_DIR.name == "notebooks":
    PROJECT_DIR = PROJECT_DIR.parent
plik = PROJECT_DIR / "data/processed/pomiary_clean.csv"
assert plik.is_file(), f"Brak przygotowanych danych: {plik}"
hash_wejscia = sha256(plik.read_bytes()).hexdigest()
df = pd.read_csv(plik, parse_dates=["czas", "data_instalacji"])
assert df.shape == (720, 14)
ID_URZADZEN = {f"U-{i:02d}" for i in range(1, 9)}
assert set(df["urzadzenie"]) == ID_URZADZEN
assert df["urzadzenie"].value_counts().eq(90).all()
assert df[["urzadzenie", "temperatura", "drgania"]].notna().all().all()
assert not df.duplicated(["czas", "urzadzenie"]).any()
df_baza = df.copy(deep=True)
print("Python:", sys.version.split()[0], "Pandas:", pd.__version__)
print("SHA-256:", hash_wejscia)
display(df.dtypes)
SHA-256 identyfikuje zawartość pliku, nie potwierdza jej jakości. Oczekiwania 720 × 14 i osiem urządzeń dotyczą danych kursowych. W innym projekcie wymagania ustalasz na podstawie źródła i celu, nie przez kopiowanie tych liczb.
Minimalna poprawka i czytelny wynik
Źródłem KeyError jest odwołanie do drgania_mm_s zamiast drgania. Nie musisz tworzyć nowego pola, przemianowywać całej ramki ani instalować bibliotek. Wystarczy użyć istniejącej nazwy. Poniższy wynik ma rozszerzony, jawny format: urzadzenie, mediana_drgan i n. Ponieważ drgania są kompletne, n oznacza zarówno liczbę rekordów, jak i dostępnych wartości.
ranking = (
    df.groupby("urzadzenie", as_index=False)
    .agg(mediana_drgan=("drgania", "median"),
         n=("drgania", "size"))
    .sort_values("mediana_drgan", ascending=False, ignore_index=True)
)
display(ranking)|
Urządzenie |
Mediana drgań w mm/s |
n |
|---|---|---|
|
U-05 |
1,3735 |
90 |
|
U-08 |
1,3605 |
90 |
|
U-07 |
1,3460 |
90 |
|
U-03 |
1,2520 |
90 |
|
U-06 |
1,2500 |
90 |
|
U-02 |
1,1575 |
90 |
|
U-04 |
1,1250 |
90 |
|
U-01 |
1,0380 |
90 |
To wartości obliczone na danych kursowych, nie wyniki odgadnięte przez model. Tabela odpowiada na pytanie o medianę w badanym okresie. U-05 ma najwyższą medianę, ale różnica względem U-08 wynosi tylko 0,0130 mm/s. Samo pierwsze miejsce nie jest diagnozą niesprawności ani oceną istotności różnicy.
Wyjaśnienie operacji
Groupby dzieli pomiary według urządzenia, agg nazywa miary wyniku, a sort_values ustala kolejność. Parametr as_index=False pozostawia identyfikator w kolumnie. Ignore_index=True porządkuje techniczny indeks po sortowaniu; nie zmienia identyfikatorów urządzeń. Taki opis pozwala sprawdzić, czy odpowiedź LLM faktycznie wyjaśnia kod, zamiast jedynie powtarzać jego nazwy.
Test wyniku i test braku skutków ubocznych
Sprawdzenie shape wykryje zmianę liczby wierszy lub kolumn, ale nie wykryje podmiany jednej wartości. Dlatego porównujesz całe df z kopią sprzed pracy. Osobno kontrolujesz wynik: nazwy pól, pełny zbiór identyfikatorów, liczebności, kolejność i wartości median obliczone drugim sposobem.
assert ranking.columns.tolist() == ["urzadzenie", "mediana_drgan", "n"]
assert set(ranking["urzadzenie"]) == ID_URZADZEN
assert ranking["urzadzenie"].is_unique
assert ranking["n"].eq(90).all()
assert ranking["mediana_drgan"].is_monotonic_decreasing
kontrola = df.pivot_table(
    index="urzadzenie", values="drgania", aggfunc="median"
)
np.testing.assert_allclose(
    ranking.set_index("urzadzenie").sort_index()["mediana_drgan"],
    kontrola.sort_index()["drgania"], rtol=1e-12, atol=1e-12
)
pd.testing.assert_frame_equal(df_baza, df)
Druga implementacja w Pandas pomaga wykryć pomyłkę w składaniu wyniku, ale nie stanowi niezależnego badania danych. Obie metody korzystają z tego samego wejścia i tej samej definicji mediany. Dlatego poprawność jednostki, sens grupowania i pochodzenie danych sprawdzasz osobno.
Funkcja z jawnymi warunkami wejścia
Refaktoryzacja pozwala użyć rozwiązania ponownie. Poniżej dodajemy walidację: wymagane kolumny muszą istnieć, tabela nie może być pusta, a identyfikatory i drgania nie mogą mieć braków. To świadome rozszerzenie zachowania; zamiast przypadkowego KeyError otrzymasz zrozumiały ValueError.
def ranking_drgan(dane):
    wymagane = {"urzadzenie", "drgania"}
    brakujace = wymagane - set(dane.columns)
    if brakujace:
        raise ValueError(f"Brak kolumn: {sorted(brakujace)}")
    if dane.empty or dane[list(wymagane)].isna().any().any():
        raise ValueError("Puste wejście lub braki w wymaganych polach")
    return (
        dane.groupby("urzadzenie", as_index=False)
        .agg(mediana_drgan=("drgania", "median"),
             n=("drgania", "size"))
        .sort_values("mediana_drgan", ascending=False, ignore_index=True)
    )
Przypadki brzegowe i zakres gwarancji
Nie dodawaj obsługi wyjątków tylko po to, aby ukryć problem. Funkcja ma zatrzymać pracę, gdy nie da się spełnić umówionego kontraktu. Dzięki temu brak identyfikatora nie zniknie po cichu podczas grupowania. W innym zastosowaniu możesz dopuścić braki drgań, ale wtedy potrzebujesz nowej reguły liczenia n i testu grup bez dostępnych wartości.
pd.testing.assert_frame_equal(ranking, ranking_drgan(df))
proby_bledne = [
    df.drop(columns="drgania"), df.iloc[:0],
    df.assign(urzadzenie=np.nan), df.assign(drgania=np.nan)
]
for proba in proby_bledne:
    try:
        ranking_drgan(proba)
    except ValueError as blad:
        print("Oczekiwane zatrzymanie:", blad)
    else:
        raise AssertionError("Funkcja przyjęła niepoprawne wejście")
pd.testing.assert_frame_equal(df_baza, df)
Oczekiwany wyjątek jest przechwycony wewnątrz testu, więc późniejsze uruchomienie wszystkich komórek nie zatrzyma się na demonstracji błędu. Test odróżnia poprawne odrzucenie nieprawidłowego wejścia od awarii niekontrolowanej. Nie przechwytuj jednak wszystkich wyjątków bez rozróżnienia: inny błąd powinien pozostać widoczny.
Podana funkcja nie jest pełnym walidatorem dowolnych danych produkcyjnych. Zakłada liczbowe drgania, a dla identycznych median nie definiuje dodatkowego kryterium kolejności. Jeśli to istotne w nowym zadaniu, rozszerz kontrakt i testy, zamiast traktować przykład jako uniwersalne rozwiązanie.
Co przyjąć z odpowiedzi modelu
Przyjmujesz poprawkę nazwy po przejściu testów. Możesz osobno przyjąć czytelniejszą strukturę funkcji. Odrzucasz zamianę mediany na średnią, globalne usuwanie braków lub zmianę nazw wejścia, jeżeli nie wynikają z zadania. Ocena „częściowo przydatne” jest bardziej precyzyjna niż bezwarunkowe przyjęcie całej odpowiedzi.
Sprawdź rozumienie 3
Po uruchomieniu kodu df nadal ma 720 wierszy i 14 kolumn. Dlaczego to za mało, aby potwierdzić brak zmian? Jak sprawdzisz poprawność rankingu oraz zachowanie funkcji po usunięciu wymaganej kolumny z kopii danych? Dlaczego zastąpienie KeyError przez ValueError trzeba opisać jako zmianę zachowania?
6. Wsparcie analizy wykresów i raportu
Pomoc w analizie nie sprowadza się do pisania kodu. LLM może zaproponować pytanie, dobrać sposób prezentacji albo uporządkować akapit raportu. Właśnie tutaj łatwo jednak o przekroczenie granic danych: ciekawy pomysł zamienia się w rzekome odkrycie, a współwystępowanie w przyczynę. Twoim zadaniem jest zachować użyteczny kierunek i usunąć nieuzasadnione twierdzenia.
Prompt M5 P02 z określonym zakresem
„Kontynuuję analizę wykresu M4_W06_temperatura_drgania.png. W danych kursowych mam 720 kompletnych par temperatura–drgania, osiem urządzeń i po 90 par na urządzenie. Temperatura jest w °C, drgania w mm/s. Samodzielnie obliczona globalna korelacja Pearsona wynosi około 0,644. Zachowano pomiar drgań 4,850 mm/s do wyjaśnienia. Dostępne pola kontekstu to urzadzenie i tryb, z kategoriami auto i oszczedny.
Zaproponuj dwa kierunki dalszej analizy. Dla każdego podaj pytanie, potrzebne dane, sposób grupowania lub porównania, odpowiedni wykres, test weryfikacyjny i ograniczenie. Nie twierdź, że znasz niewyliczone wyniki. Nie wyprowadzaj przyczynowości, nie usuwaj punktów i nie traktuj nazwy trybu jako dowodu działania. Zwróć także neutralny szablon wniosku, który uzupełnię dopiero po obliczeniach”.
Ten prompt przekazuje sprawdzony wynik jako kontekst, ale nie daje modelowi prawa do wymyślania wyników w grupach. Nie musisz dołączać całego CSV. Do sformułowania dwóch kierunków wystarczą opis danych, jednostki i ograniczenia; do ich oceny potrzebujesz lokalnych obliczeń.
Dwie propozycje dydaktyczne
Pierwsza odpowiedź brzmi: „Policz korelację osobno dla urządzeń i ustal, w którym temperatura najmocniej wpływa na drgania”. Druga: „Tryb oszczedny redukuje drgania; pokaż poprawę na wykresie średnich”. Obie są przygotowanymi przykładami do ćwiczenia oceny, nie wynikami rozmowy z konkretnym modelem.
W pierwszej propozycji zachowasz podział na urządzenia, ale sprawdzisz wyniki i poprawisz język przyczynowy. W drugiej sprawdzisz porównanie trybów, zanim dopuścisz wniosek o redukcji. Nie wybieraj od razu wykresu potwierdzającego sugerowaną „poprawę”: najpierw ustal, czy przesłanka ma oparcie w danych.
M5 U02 Korelacja globalna i korelacje w grupach
Korelacja Pearsona opisuje kierunek i siłę liniowego związku dwóch zmiennych. Wynik globalny łączy zmienność wewnątrz urządzeń i różnice między urządzeniami. Nie jest średnią ośmiu korelacji grupowych. Dlatego rozdzielenie grup może zmienić interpretację, nawet jeśli żaden rekord nie zostanie usunięty.
pary = df[["urzadzenie", "temperatura", "drgania"]].dropna()
assert len(pary) == 720
r_global = pary["temperatura"].corr(pary["drgania"])
korelacje = pd.DataFrame([
    {"urzadzenie": u, "n_par": len(g),
     "r": g["temperatura"].corr(g["drgania"])}
    for u, g in pary.groupby("urzadzenie")
])
assert set(korelacje["urzadzenie"]) == ID_URZADZEN
assert korelacje["n_par"].eq(90).all()
assert korelacje["r"].notna().all()
print("Korelacja globalna:", round(r_global, 3))
display(korelacje.round(3))
Wynik globalny wynosi około 0,644. Korelacje w urządzeniach mieszczą się od około 0,102 dla U-05 do 0,778 dla U-07. Wynik globalny jest większy niż korelacja w siedmiu z ośmiu urządzeń. Te liczby pokazują, że opis całego zbioru nie zastępuje opisu każdej grupy.
Co trzeba obejrzeć poza współczynnikiem
Wykres rozrzutu ujawnia kształt zależności, zakres wartości i obserwacje o dużym wpływie. Dwa zbiory mogą mieć podobny współczynnik, lecz zupełnie inny układ punktów. Szczególnie ważny jest U-05: pomiar 4,850 mm/s współwystępuje z temperaturą 62,72 °C i wyraźnie odbiega od pozostałych drgań tego urządzenia.
W kolejnej sekcji pokazano osiem paneli ze wspólnymi skalami. Każdy punkt odpowiada parze pomiarów; punkt zachowany do wyjaśnienia wyróżniono dodatkowo obwódką. Wspólna skala utrudnia dostrzeżenie drobnych różnic przy typowych drganiach, ale uczciwie pokazuje rozmiar nietypowego pomiaru. Ewentualne powiększenie zakresu należałoby oznaczyć i przedstawić jako widok dodatkowy, nie zastąpić nim pełny obraz.
Wykres jako kontrola interpretacji
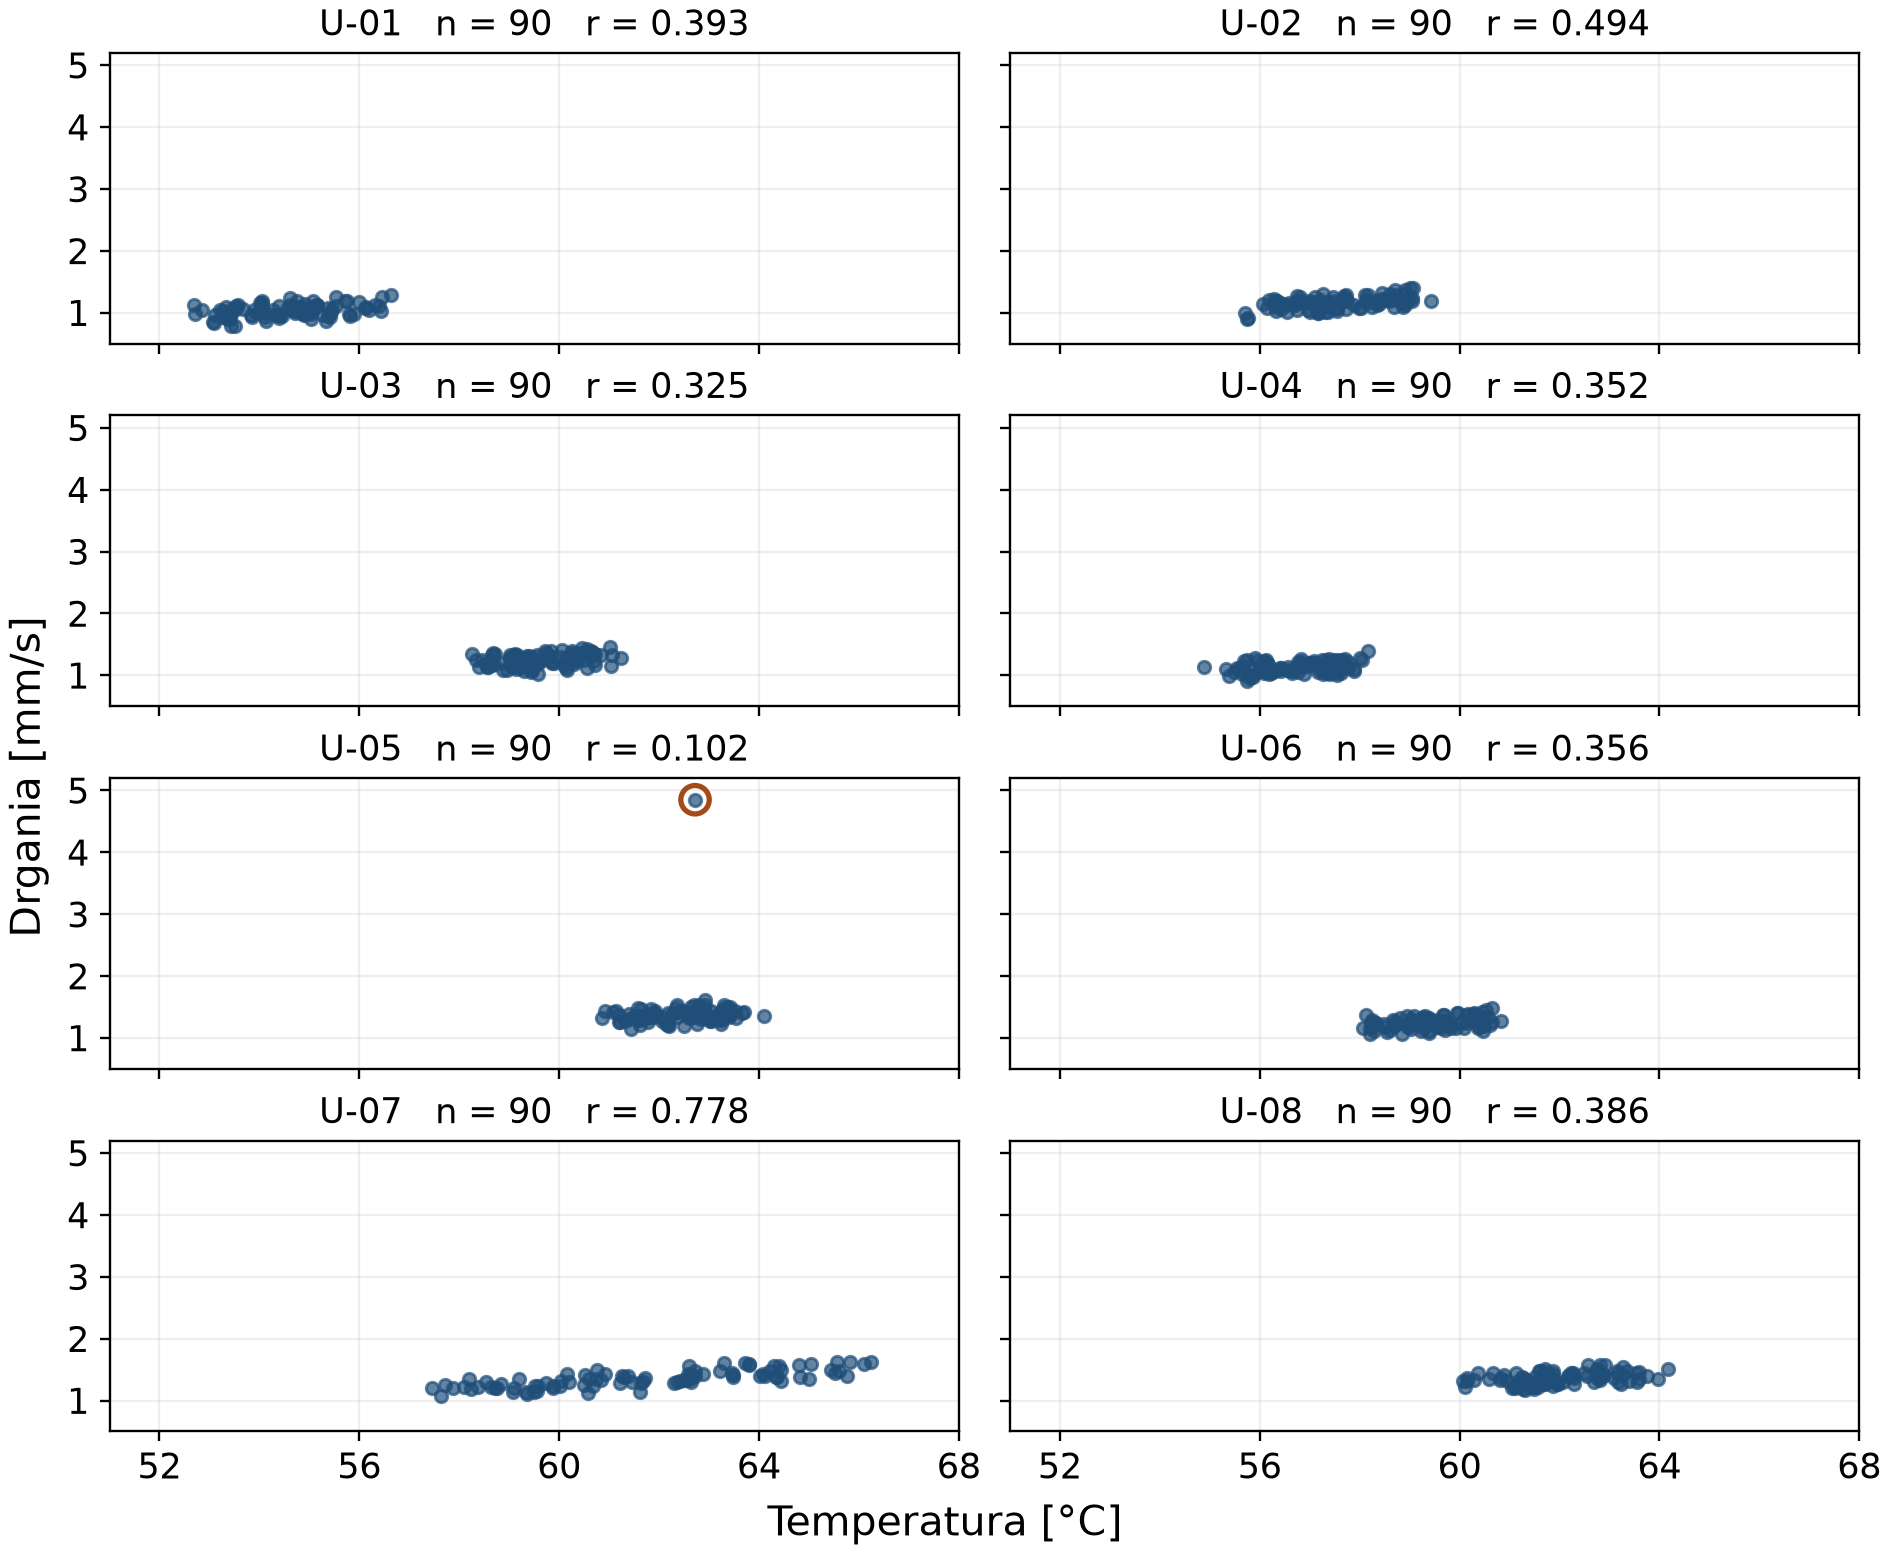
Rysunek 1. Temperatura i drgania według urządzenia. Obliczenia i wykres na danych kursowych pomiary_clean.csv; wszystkie 720 par zachowano. Współczynnik r i liczebność n podano w tytułach paneli. To ilustracja książkowa, nie dodatkowy obowiązkowy plik do oddania.
Poprawiony wniosek może brzmieć: „W badanym zbiorze temperatura i drgania są dodatnio skorelowane globalnie, ale siła liniowego związku różni się między urządzeniami. Korelacje grupowe i wykresy nie pozwalają utożsamić wyniku globalnego z relacją wewnątrz każdego urządzenia. Pomiar U-05 wymaga dodatkowego wyjaśnienia. Analiza nie ustala, czy temperatura powoduje zmianę drgań”.
Werdykt dla M5-U02 to „przyjęto po korekcie”: przydatne jest rozdzielenie grup, nieuzasadnione jest słowo „wpływa”. Różnica współczynników sama w sobie nie dowodzi statystycznej istotności różnic między urządzeniami. Pomiary powtarzają się w czasie, więc także założenie niezależności obserwacji wymagałoby oceny przed formalnym wnioskowaniem.
M5 U03 Czy nazwa trybu oznacza mniejsze drgania
Nazwa oszczedny jest etykietą kategorii, nie wynikiem badania. Nie wynika z niej, że tryb musi zmniejszać drgania, a nawet niższa obserwowana wartość nie dowodziłaby efektu przyczynowego. Najpierw porównujesz dostępne pomiary w obu trybach i sprawdzasz, jak wybór miary wpływa na opis.
tryby = (
    df.groupby("tryb", as_index=False)
    .agg(n=("drgania", "size"), mediana=("drgania", "median"),
         srednia=("drgania", "mean"), maksimum=("drgania", "max"))
)
assert set(tryby["tryb"]) == {"auto", "oszczedny"}
assert tryby["n"].eq(360).all()
display(tryby.round(4))
mediany_trybow = df.pivot_table(
    index="urzadzenie", columns="tryb", values="drgania",
    aggfunc="median"
)
roznica = mediany_trybow["oszczedny"] - mediany_trybow["auto"]
display(roznica.rename("oszczedny_minus_auto"))|
Tryb |
n |
Mediana w mm/s |
Średnia w mm/s |
|---|---|---|---|
|
auto |
360 |
1,2440 |
1,2379 |
|
oszczedny |
360 |
1,2420 |
1,2533 |
Globalna mediana w trybie oszczedny jest niższa o 0,0020 mm/s, lecz średnia jest wyższa. Maksimum wynosi 4,850 mm/s w trybie oszczedny i 1,618 mm/s w auto. Mediany w urządzeniach nie wskazują jednolitego kierunku: różnica oszczedny minus auto jest ujemna w trzech urządzeniach, zerowa w jednym i dodatnia w czterech; zakres to od −0,016 do +0,022 mm/s.
Taki wynik nie uzasadnia zdania „tryb oszczędny redukuje drgania”. Nie dowodzi też, że efekt trybu na pewno nie istnieje. Dostarcza opisu obserwacji i wskazuje, że prosta historia o jednolitej poprawie jest zbyt mocna. Do lepszego porównania użyteczny byłby wykres rozkładów z liczebnościami oraz podziałem na urządzenia, nie wyłącznie słupki dwóch średnich.
Analiza wrażliwości bez usuwania danych
Możesz sprawdzić, jak pojedynczy pomiar wpływa na średnią, nie uznając go automatycznie za błąd. Utwórz wariant diagnostyczny w odrębnej zmiennej. Wykluczenie identyfikuj jednoznacznym kluczem czasu i urządzenia, a nie ogólnym poleceniem „usuń wartości odstające”.
punkt = (
    df["urzadzenie"].eq("U-05")
    & df["czas"].eq(pd.Timestamp("2026-02-08 20:00"))
)
assert punkt.sum() == 1
assert np.isclose(df.loc[punkt, "drgania"].iloc[0], 4.850)
diagnostyczny = df.loc[~punkt].copy()
srednia_pelna = df.loc[df["tryb"].eq("oszczedny"), "drgania"].mean()
srednia_diag = diagnostyczny.loc[
    diagnostyczny["tryb"].eq("oszczedny"), "drgania"
].mean()
print("Pełny zbiór:", srednia_pelna, "Diagnostycznie:", srednia_diag)
pd.testing.assert_frame_equal(df_baza, df)
Średnia w trybie oszczedny zmienia się z około 1,2533 do 1,2432 mm/s po pominięciu jednego punktu w wariancie diagnostycznym. Zmieniła się też liczba obserwacji tego trybu: z 360 do 359. To dowód wrażliwości miary na wskazany pomiar, nie podstawa do trwałego skasowania rekordu ani potwierdzenie przyczyny jego wystąpienia.
Od obliczeń do akapitu raportu
Dobry opis łączy obserwację, podstawę obliczeń i ograniczenie. Przykład: „W pełnym zbiorze mediany drgań w trybach auto i oszczedny wynoszą odpowiednio 1,244 i 1,242 mm/s, przy 360 obserwacjach każdego trybu. Kierunek różnic median zależy od urządzenia. Średnia trybu oszczedny jest wrażliwa na zachowany pomiar 4,850 mm/s. Dane nie uzasadniają wniosku o przyczynowej redukcji drgań przez tryb”.
Dla pierwotnej tezy M5-U03 przyjmij werdykt „odrzucono”. Samo neutralne porównanie trybów pozostaje użytecznym pytaniem, ale nie jest tym samym co przyjęcie tezy o redukcji. W rejestrze oddziel te dwie rzeczy. Jeśli Twoje własne odpowiedzi LLM nie dają przykładu do odrzucenia, przeanalizuj ten przygotowany przypadek, zamiast wymuszać nieuczciwy werdykt.
Sprawdź rozumienie 4
Dlaczego korelacja globalna nie opisuje automatycznie każdego urządzenia? Co możesz powiedzieć po zmianie średniej w wariancie bez jednego punktu, a czego nadal nie wiesz? Sformułuj neutralny odpowiednik zdania „tryb oszczędny poprawia stan urządzeń”.
7. Protokół weryfikacji odpowiedzi LLM
Odpowiedź modelu bywa mieszaniną poprawnego pomysłu, błędu w kodzie i zbyt mocnego wniosku. Ocena całego akapitu jednym słowem zaciera te różnice. Stosuj protokół: wyodrębnij twierdzenie, dobierz dowód, wykonaj sprawdzenie, wydaj werdykt i zapisz ograniczenie. Każdy werdykt powinien wskazywać konkretną część odpowiedzi.
Twierdzenie dowód werdykt
Rozważ odpowiedź dydaktyczną: „Pogrupuj po linia, usuń wszystkie wiersze z brakami przez dropna(), policz korelację temperatury i drgań. Wynik około 0,64 potwierdza, że temperatura powoduje wzrost drgań”. To nie jedno twierdzenie, lecz co najmniej cztery niezależne kwestie.
|
Twierdzenie |
Właściwy dowód |
Decyzja |
|---|---|---|
|
T1 Istnieje pole linia |
Lista kolumn i słownik |
Odrzucić: takiej kolumny nie ma |
|
T2 Globalne dropna jest właściwe dla tej korelacji |
Liczba kompletnych par przed i po operacji |
Odrzucić procedurę; kontrolować tylko potrzebne pola |
|
T3 Korelacja wynosi około 0,64 |
Własne obliczenie na 720 określonych parach |
Przyjąć liczbę po weryfikacji i podaniu zakresu |
|
T4 Temperatura powoduje wzrost drgań |
Projekt badania i dowody przyczynowe |
Odrzucić jako nieuzasadnione tą analizą |
Nie zastępuj linia przez lokalizacja tylko dlatego, że nazwa wydaje się podobna. Oznaczałoby to samodzielną zmianę grupowania. Najpierw wróć do pytania: w przykładzie M5-U02 właściwe grupy to urządzenia. Słownik wyjaśnia znaczenie istniejących pól, ale nie wybiera celu analizy za Ciebie.
Jak nazwać częściowe wykorzystanie
Jeżeli odrzucasz twierdzenie „globalne usuwanie braków jest właściwe”, nie zapisuj, że to twierdzenie przyjęto. Możesz przyjąć po korekcie użyteczny zamiar sprawdzenia kompletności par. Wpis powinien zawierać zarówno odrzuconą procedurę, jak i nową regułę: wybór pól wymaganych przez konkretną analizę. Dzięki temu nie nadajesz błędnej odpowiedzi pozoru poprawności.
Dlaczego globalne usuwanie braków zmienia próbę
Brak energii nie przeszkadza w analizie pary temperatura–drgania, jeżeli oba te pomiary istnieją. Podobnie brak produkcji nie uzasadnia usunięcia dostępnej energii przy liczeniu jej średniej. Zakres operacji dropna musi wynikać z konkretnego pytania.
liczby = {
    "wszystkie_rekordy": len(df),
    "po_globalnym_dropna": len(df.dropna()),
    "pary_temperatura_drgania": len(
        df.dropna(subset=["temperatura", "drgania"])
    ),
    "dostepna_energia": int(df["energia"].count()),
    "dostepna_produkcja": int(df["produkcja"].count())
}
assert list(liczby.values()) == [720, 717, 720, 718, 719]
display(pd.Series(liczby))
pd.testing.assert_frame_equal(df_baza, df)
Globalne dropna pozostawia 717 rekordów. Dla korelacji temperatury i drgań dostępnych jest 720 kompletnych par; dla energii 718 wartości. Gdybyś globalnie usunął braki przed obliczeniem energii, straciłbyś dodatkowo poprawny pomiar z rekordu z brakującą produkcją. Ta różnica nie jest kosmetyczna: zmienia zestaw obserwacji, na którym opiera się wynik.
Mały kontrprzykład lepszy niż zapewnienie modelu
Poniższe trzy wiersze są syntetycznym testem, nie dodatkiem do danych kursowych. Pozwalają odróżnić size, count i mean na przykładzie, który policzysz także ręcznie.
mini = pd.DataFrame({
    "urzadzenie": ["T", "T", "T"], "energia": [10.0, np.nan, 14.0]
})
kontrola_mini = mini.groupby("urzadzenie")["energia"].agg(
    ["size", "count", "mean"]
)
assert kontrola_mini.loc["T"].tolist() == [3, 2, 12]
display(kontrola_mini)
Size liczy trzy rekordy, count dwie dostępne wartości, a mean daje 12 z dwóch pomiarów. Wpisanie zera dałoby średnią 8 i oznaczałoby udawanie, że brakujący odczyt był równy zero. Test ujawnia zmianę znaczenia operacji, nawet gdy kod nie zgłasza żadnego błędu.
Sprawdzenie korelacji drugim sposobem
Wartość r możesz zweryfikować przez definicję: odejmij od każdej zmiennej jej średnią, policz sumę iloczynów odchyleń i podziel przez iloczyn długości wektorów odchyleń. Poniższy blok używa tych samych kompletnych par co poprzednia analiza, lecz nie wywołuje metody corr do wyznaczenia wyniku kontrolnego.
xy = df[["temperatura", "drgania"]].dropna()
assert len(xy) >= 2
x = xy["temperatura"].to_numpy(dtype=float)
y = xy["drgania"].to_numpy(dtype=float)
xc, yc = x - x.mean(), y - y.mean()
mianownik = np.sqrt((xc @ xc) * (yc @ yc))
assert mianownik > 0, "Korelacja nieokreślona dla stałej zmiennej"
r_kontrolne = float((xc @ yc) / mianownik)
assert np.isclose(r_kontrolne, r_global, rtol=1e-12, atol=1e-12)
print("Wynik według definicji:", r_kontrolne)
Otrzymasz około 0,644407. Zgodność wzmacnia zaufanie do obliczenia współczynnika. Nie sprawdza jednak poprawności czujnika, reprezentatywności okresu ani przyczynowości. Niezależność sposobu obliczeń nie oznacza niezależności danych: oba wyniki pochodzą z tych samych obserwacji.
Dobór źródła do pytania
Dokumentacja biblioteki jest właściwa do sprawdzania parametrów funkcji, domyślnego traktowania braków czy typu wyniku. W lokalnym środowisku możesz skorzystać także z help() i małego przykładu. Zapis wersji Pandas pomaga odtworzyć zachowanie. Sama dokumentacja nie potwierdzi jednak, że Twoja kolumna oznacza energię w kWh ani że wzrost temperatury spowodował zmianę drgań.
Weryfikacja powinna być proporcjonalna do ryzyka. Literówkę sprawdzisz schematem i testem. Zmianę czyszczenia — porównaniem danych i liczebności. Wniosek analityczny — obliczeniem, wykresem, kontekstem i oceną ograniczeń. Decyzja operacyjna o urządzeniu wymaga dodatkowych dowodów i uprawnionego procesu, których ten notebook nie zastępuje.
Nowy przypadek energii i nieuzasadniona rekomendacja
Odpowiedź dydaktyczna brzmi: „U-05 ma najwyższą średnią energię, około 15,411 kWh, więc jest najmniej efektywne. Uzupełnij brakującą energię zerami i wyłącz urządzenie”. Oddziel cztery kwestie: wartość średniej, interpretację efektywności, imputację i działanie operacyjne. Każda wymaga innego rodzaju dowodu.
energia_urz = (
    df.groupby("urzadzenie")["energia"]
    .agg(n="count", srednia="mean")
    .sort_values("srednia", ascending=False)
)
assert energia_urz["n"].sum() == 718
assert energia_urz["srednia"].idxmax() == "U-05"
display(energia_urz.round(3))
Obliczenie potwierdza pierwszą liczbę w granicach zaokrąglenia. U-03 i U-04 mają po 89 dostępnych wartości energii, pozostałe urządzenia po 90. Raportowanie count przy średniej zapobiega udawaniu, że wszystkie grupy opierają się na pełnych danych.
|
Część odpowiedzi |
Werdykt |
Dlaczego |
|---|---|---|
|
Najwyższa średnia energii U-05 |
Przyjęto po sprawdzeniu |
Wynika z agregacji istniejących wartości; podano n |
|
Najmniejsza efektywność |
Odrzucono jako nieudowodnione |
Sama energia nie uwzględnia produkcji, obciążenia ani funkcji urządzenia |
|
Uzupełnienie energii zerami |
Odrzucono |
Brak odczytu nie oznacza pomiaru zerowego |
|
Wyłączenie urządzenia |
Odrzucono w tym zadaniu |
Brak diagnozy i podstaw do decyzji operacyjnej |
Do oceny efektywności potrzebowałbyś uzasadnionej miary odnoszącej energię do efektu pracy i porównywalnych warunków. Sam iloraz też wymaga ustalenia zgodności okresów, jednostek oraz obsługi braków i zer w mianowniku. Nie dopisuj go odruchowo jako „dowodu”, zanim zdefiniujesz pytanie.
Sprawdź rozumienie 5
Model podał poprawną liczbę i dołączył do niej nieuzasadnioną rekomendację. Czy poprawność liczby przenosi się na rekomendację? Jakie osobne werdykty zapiszesz dla średniej energii, efektywności, wstawiania zer i wyłączenia urządzenia?
8. Rejestr użycia LLM i ocena wartości
Rejestr jest częścią uzasadnienia wyniku. Powinien pozwalać odtworzyć, czego dotyczyła pomoc modelu, jakie informacje otrzymał, co zaproponował, co sprawdzono i jaki wpływ miała odpowiedź. Sam zapis „korzystano z AI” jest zbyt ogólny. Z kolei bezładny eksport całej rozmowy może ukrywać decyzje w nadmiarze tekstu i niepotrzebnie przechowywać dane.
Osiem części wpisu szczegółowego
W notebooku utwórz sekcję „Udokumentowane wykorzystanie LLM”. Wpisy oznaczaj stałymi identyfikatorami, na przykład M5-L01. Odwołanie do takiego nagłówka jest stabilniejsze niż numer wykonania komórki, który zmienia się po ponownym uruchomieniu.
|
Część wpisu |
Co zapisać |
|---|---|
|
1 Identyfikator i cel |
ID wpisu, ID przypadku z mapy i konkretne zadanie |
|
2 Środowisko |
Rzeczywisty model, wersja lub tag, interfejs, dostępne ustawienia i data; przy offline jawny brak wywołania |
|
3 Kontekst |
Dokładnie to, co przekazano modelowi; osobno dane użyte tylko lokalnie do testów |
|
4 Prompt |
Pełne polecenie z wersją lub stabilne odwołanie do zachowanej treści |
|
5 Odpowiedź |
Istotny fragment bez zmiany sensu; jeśli to streszczenie, oznacz je i zachowaj oryginał |
|
6 Weryfikacja |
Metoda testu, rzeczywisty wynik i miejsce dowodu w notebooku lub tabeli |
|
7 Werdykt |
Przyjęto, przyjęto po korekcie albo odrzucono, wraz z uzasadnieniem |
|
8 Wpływ i wartość |
Co wykorzystano w analizie, koszt kontroli, korzyść, ryzyko i pozostałe ograniczenia |
Oddziel kontekst przekazany od kontekstu testowego. Jeżeli model dostał tylko schemat i kod, nie wpisuj, że analizował cały plik 720 × 14. Nazwę i SHA-256 lokalnego pliku możesz zapisać w części o dowodzie, wyraźnie wskazując, że obliczenia wykonał uczestnik, a nie model.
Nie poprawiaj po cichu cytowanej odpowiedzi, aby pasowała do ostatecznej decyzji. Zachowaj oryginalny fragment, a własną korektę opisz obok. Usuń z dokumentacji sekrety i niedozwolone dane; najlepiej w ogóle nie przekazywać ich do rozmowy. Zakres utrwalanych materiałów także powinien odpowiadać potrzebom i zasadom projektu.
Trzy przykłady decyzji w rejestrze
Poniższe wpisy są skróconymi wzorami dydaktycznymi opartymi na przykładach z tej książki. Nie opisują rzeczywistych wywołań modelu. W swoim notebooku uzupełnij je o wykonane przez siebie testy i ich lokalizację. Jeśli ćwiczysz z modelem, zamiast tych odpowiedzi użyj faktycznej treści uzyskanej w rozmowie.
M5 L01 Poprawka rankingu
Cel i kontekst: M5-U01, prompt M5-P01 v1, schemat urzadzenie i drgania, kod z nieistniejącą nazwą drgania_mm_s. Źródło propozycji: odpowiedź dydaktyczna B, wariant offline, bez wywołania modelu. Propozycja: użyć istniejącej kolumny i zachować medianę. Liczby z danych nie były częścią przekazanego wyniku modelu.
Dowód: ranking z rozdziału 3 ma osiem unikalnych urządzeń, n = 90 w każdej grupie i malejącą medianę; alternatywna agregacja potwierdza wartości, a pełne porównanie df potwierdza brak zmian. Werdykt: przyjęto poprawkę nazwy po teście. Wpływ: kod działa zgodnie z pytaniem. Dodatkowe opakowanie w funkcję i walidacja są osobno opisanym rozszerzeniem. Nie deklarowano pomiaru oszczędności czasu.
M5 L02 Korelacje w urządzeniach
Cel i kontekst: M5-U02, prompt M5-P02, schemat i zweryfikowana globalna korelacja. Źródło: pierwsza odpowiedź dydaktyczna z rozdziału 4. Propozycja: rozdzielić urządzenia i ocenić, gdzie temperatura „wpływa” na drgania.
Dowód: 720 kompletnych par, osiem grup po 90, korelacje od około 0,102 do 0,778 i pełne wykresy rozrzutu. Werdykt: przyjęto po korekcie — wykorzystano podział na grupy, odrzucono interpretację przyczynową. Wpływ: opis ograniczono do związku statystycznego; odnotowano punkt U-05 i powtarzalność pomiarów w czasie. Koszt obejmuje dodatkowe obliczenia, wykres i kontrolę narracji.
M5 L03 Teza o trybie pracy
Cel i kontekst: M5-U03, ten sam M5-P02 i dostępne kategorie trybu. Źródło: druga odpowiedź dydaktyczna. Propozycja: pokazać rzekomą redukcję drgań w trybie oszczedny.
Dowód: 360 rekordów każdego trybu, różne kierunki różnic median w urządzeniach oraz wrażliwość średniej na jeden zachowany punkt. Werdykt: odrzucono tezę o wykazanej redukcji. Wpływ: do raportu trafia neutralne porównanie i ograniczenie, bez deklaracji poprawy stanu urządzeń. Korzyść z uniknięcia błędnego wniosku wynika z weryfikacji, a nie z poprawności pierwotnej sugestii.
Siedem kolumn wspólnego pliku CSV
Projekt korzysta z docs/rejestr_uzycia_LLM.csv. Zachowaj istniejący schemat: modul, cel, prompt, odpowiedz_modelu, test_weryfikacyjny, werdykt, uzasadnienie. Osiem części wpisu szczegółowego nie oznacza konieczności dodania ośmiu kolumn. CSV może być krótkim indeksem prowadzącym do pełnej dokumentacji w notebooku.
|
Kolumna CSV |
Zawartość dla M5 |
|---|---|
|
modul |
M5 |
|
cel |
ID wpisu i zadania, np. M5-L01 / M5-U01, oraz krótki cel |
|
prompt |
Wersja promptu i odwołanie do pełnej treści w notebooku |
|
odpowiedz_modelu |
Fragment lub oznaczone streszczenie; przy offline wskazanie przykładu dydaktycznego |
|
test_weryfikacyjny |
Wykonany test, rzeczywisty wynik i miejsce dowodu |
|
werdykt |
Jednoznaczna decyzja dotycząca konkretnej propozycji |
|
uzasadnienie |
Powód, wpływ na analizę, koszt i ograniczenie; odwołanie do wpisu szczegółowego |
Metadane środowiska i dokładny kontekst pozostają w szczegółowym wpisie. Nie zastępuj ich ogólnikiem „model lokalny”, jeżeli znasz nazwę i tag. Jeśli nie znasz ustawienia albo wersji, napisz „nieodnotowano” zamiast zgadywać. Przy wariancie offline pole odpowiedz_modelu nadal istnieje ze względu na wspólny schemat, lecz treść wyraźnie zaznacza brak rzeczywistego wywołania.
Przy uzupełnianiu CSV zachowuj wpisy wcześniejszych modułów. Nie umieszczaj bezwarunkowego dopisywania rekordów w każdorazowo wykonywanej komórce, bo ponowne uruchomienie notebooka powieli historię. Przed zapisem sprawdź istniejący ID i zdecyduj, czy aktualizujesz wpis, czy dodajesz nowy. Treści promptów zawierające przecinki i nowe linie zapisuj poprawnym narzędziem CSV, nie przez ręczne łączenie pól przecinkami.
Wartość po uwzględnieniu kontroli
Korzyść z szybkiego napisania kodu może zniwelować koszt korekt i testów. Przy prostym KeyError samodzielne rozwiązanie bywa szybsze. Przy nowym porównaniu wartością może być poszerzenie analizy, nie skrócenie pracy. Oceniaj konkretny przypadek.
Bez pomiaru czasu podaj ocenę jakościową i poniesiony koszt, nie procent oszczędności. Rejestruj także odrzucone odpowiedzi: uzasadnienie chroni przed późniejszym bezkrytycznym przywróceniem błędnej tezy do raportu.
9. Pełny workflow i zakończenie modułu
Praca z LLM kończy się wtedy, gdy potrafisz odtworzyć obliczenia, wskazać dowody i rozdzielić wkład modelu od własnych decyzji. Poniższa kolejność łączy sześć rozdziałów w jeden proces.
|
Etap |
Rezultat i warunek przejścia dalej |
|---|---|
|
Wybór zastosowania |
Mapa ryzyka, dozwolone środowisko i minimalny kontekst |
|
Specyfikacja |
Prompt z celem, schematem, ograniczeniami i kryteriami |
|
Pozyskanie propozycji |
Zachowana rzeczywista odpowiedź lub jawny przykład offline |
|
Przegląd przed wykonaniem |
Sprawdzone nazwy, miary, skutki uboczne i zakres kodu |
|
Weryfikacja lokalna |
Testy struktury i wartości, wykresy oraz niezmienione wejście |
|
Decyzja i dokumentacja |
Werdykt dla każdej istotnej części odpowiedzi, dowód i ograniczenie |
|
Odtworzenie i przekazanie |
Czyste uruchomienie, spójne nazwy, opis gotowy do dalszego raportu |
Opcjonalne tabele wynikowe
Poniższe trzy tabele są nowymi wynikami obliczeń, nie plikami wejściowymi z pakietu. Ich nazwy odpowiadają karcie pracy. Zapis aktualizuje wyniki; wcześniejszą wersję, którą chcesz zachować, zarchiwizuj przed ponownym wykonaniem.
TABLES = PROJECT_DIR / "outputs/tables"
TABLES.mkdir(parents=True, exist_ok=True)
wyniki = {
    "M5_U01_ranking_drgan.csv": ranking,
    "M5_U02_korelacje_urzadzenia.csv": korelacje,
    "M5_U03_drgania_tryb.csv": tryby
}
for nazwa, tabela in wyniki.items():
    sciezka = TABLES / nazwa
    tabela.to_csv(sciezka, index=False, encoding="utf-8")
    odczyt = pd.read_csv(sciezka)
    pd.testing.assert_frame_equal(tabela, odczyt, rtol=1e-10, atol=1e-10)
assert sha256(plik.read_bytes()).hexdigest() == hash_wejscia
pd.testing.assert_frame_equal(df_baza, df)
Na końcu zapisz notebook, zrestartuj kernel i uruchom wszystkie komórki od góry. Nie wywołuj ponownie modelu ani nie dopisuj rejestru tylko po to, by odtworzyć obliczenia: zachowane odpowiedzi są wejściem do audytu.
10. Gotowość do modułu 6
Do kolejnego modułu przekaż wyniki wraz z metodą, ograniczeniami i krótką informacją o wykorzystaniu LLM, odsyłającą do wpisów M5-L01–M5-L03. Szczegóły pozostają w notebooku i rejestrze. Odbiorca raportu powinien rozumieć wynik bez czytania całej historii rozmów, ale mieć możliwość sprawdzenia jego pochodzenia.
Lista gotowości
- Potrafię wskazać zadanie odpowiednie dla LLM i takie, którego mu nie powierzam.
- Prompty zawierają rzeczywisty schemat, ograniczenia i sprawdzalne kryteria.
- Rozumiem wykorzystany kod, a wyniki przechodzą lokalne testy po restarcie kernela.
- Nie zmieniono wejściowego CSV; braki i nietypowy pomiar pozostają jawne.
- Wnioski odróżniają opis obserwacji od nieudowodnionej przyczynowości.
- Mam trzy udokumentowane przypadki z dowodami i uczciwie oznaczonym źródłem odpowiedzi.
- Rejestr i notebook pozwalają odtworzyć, co przyjęto, poprawiono i odrzucono.
Krótka informacja do raportu
Przykład dla wariantu offline: „W ramach modułu przeanalizowano przygotowane przykłady odpowiedzi LLM. Nie wykonywano wywołań modelu. Kod i twierdzenia sprawdzono lokalnie na danych kursowych, a decyzje zapisano we wpisach M5-L01–M5-L03”. Użyj takiego opisu tylko wtedy, gdy odpowiada Twojej rzeczywistej pracy. Przy pracy z modelem podaj faktyczny zakres jego udziału i odsyłacze do właściwych wpisów.
Podstawa opracowania
Materiał rozwija prezentację M5-v2.pptx i jej notatki, zgodnie z sześcioma rozdziałami modułu. Nazewnictwo i organizacja pracy odpowiadają karcie M5_Instrukcja_praca_z_LLM.docx. Przykłady liczbowe opierają się na przygotowanym zbiorze kursowym pomiary_clean.csv; kontekst wizualizacji pochodzi z modułu 4. Treści potrzebne do lektury, przykłady odpowiedzi i wyniki kontrolne znajdują się w tej książce.
Sprawdź rozumienie 6
Dlaczego pełna historia rozmowy nie zastępuje wpisu z testem i werdyktem? Jak odróżnisz dane przekazane modelowi od danych użytych tylko lokalnie? Kiedy pomoc modelu może nie przynieść oszczędności czasu, mimo że wygenerował poprawny kod?
11. Podsumowanie i odpowiedzi do samooceny
Najważniejszą kompetencją modułu jest kontrolowane wykorzystanie propozycji. Potrafisz ograniczyć kontekst, napisać sprawdzalny prompt, przetestować kod, skorygować interpretację i udokumentować decyzję. Przyjęcie, korekta i odrzucenie są równoprawnymi rezultatami analizy odpowiedzi, o ile każde wynika z dowodów.
Odpowiedzi do pytań
1. Bez dostępu do danych model może zaproponować metodę lub kod, lecz nie ma podstaw do podania rzeczywistych median Twojego zbioru. Ranking z liczbami trzeba obliczyć samodzielnie. Do naprawy nazwy wystarczą odpowiednie kolumny schematu, jednostka, błędny fragment i opis oczekiwanego wyniku; pełny CSV nie jest potrzebny.
2. Usunięcie wyjątku nie wystarcza: zmiana mediany na średnią narusza cel, a przemianowanie df narusza warunek niezmienności wejścia. Offline porównujesz przygotowane przykłady z kryteriami i jasno zaznaczasz, że nie wykonałeś dwóch rozmów. Nie przypisujesz ich rzeczywistemu modelowi ani nie oceniasz na tej podstawie jego skuteczności.
3. Shape nie wykrywa podmiany wartości, typów czy kolejności przy zachowanym rozmiarze. Pełne porównanie z kopią sprawdza więcej własności. Ranking kontrolujesz przez identyfikatory, n, kolejność i alternatywną agregację. Brak wymaganej kolumny na kopii powinien wywołać oczekiwany ValueError. Zmiana rodzaju wyjątku jest celowym rozszerzeniem interfejsu funkcji, nie samym uporządkowaniem zapisu.
4. Wynik globalny obejmuje także różnice między urządzeniami; nie jest średnią korelacji grupowych. Zmiana średniej po pominięciu punktu pokazuje jej wrażliwość, lecz nie dowodzi błędu pomiaru. Neutralny wniosek opisuje mediany i rozkłady w trybach oraz zróżnicowanie między urządzeniami, bez przypisywania trybowi poprawy stanu technicznego.
5. Poprawna liczba nie uzasadnia dowolnej interpretacji. Średnią U-05 można przyjąć po sprawdzeniu dostępnych wartości i n. Tezę o najmniejszej efektywności odrzucasz jako nieudowodnioną samą energią. Zera odrzucasz jako nieuzasadnione zastąpienie braków. Wyłączenie urządzenia wykracza poza dowody i zakres tego zadania.
6. Historia rozmowy przechowuje wypowiedzi, ale nie musi wskazywać wykonanej kontroli ani ostatecznej decyzji. W rejestrze osobno opisujesz przekazany schemat i lokalny zbiór testowy. Koszt przygotowania kontekstu, sprawdzenia kodu, korekt i dokumentowania może przewyższyć czas samodzielnego rozwiązania. Bez pomiaru nie deklarujesz liczbowej oszczędności.
12. Słownik pojęć
|
Pojęcie |
Znaczenie w module |
|---|---|
|
LLM |
Duży model językowy tworzący odpowiedzi na podstawie dostępnego kontekstu |
|
Prompt |
Polecenie wraz z informacjami i warunkami potrzebnymi do zadania |
|
Kontekst |
Materiały rzeczywiście dostępne modelowi; nie cała wiedza uczestnika |
|
Halucynacja |
Wiarygodnie brzmiąca, lecz niepoparta lub błędna treść, np. wymyślone pole lub wynik |
|
Kryterium akceptacji |
Warunek, którego spełnienie można sprawdzić po otrzymaniu propozycji |
|
Debugowanie |
Ustalanie i usuwanie przyczyny błędu przy zachowaniu sensu zadania |
|
Refaktoryzacja |
Zmiana struktury kodu bez niezamierzonej zmiany uzgodnionego zachowania |
|
Przypadek brzegowy |
Wejście ujawniające ograniczenia, np. pusta tabela lub brak wymaganej kolumny |
|
Analiza wrażliwości |
Kontrolowane sprawdzenie, jak wynik zależy od wskazanego założenia lub obserwacji |
|
Korelacja |
Miara współzmienności; w tym module liniowy związek opisany współczynnikiem Pearsona |
|
Werdykt |
Uzasadniona decyzja o wykorzystaniu konkretnej części odpowiedzi |
|
Rejestr użycia |
Ślad od celu i promptu przez odpowiedź i dowód do decyzji oraz wpływu |