Podręcznik uczestnika z objaśnieniami, przykładami i ćwiczeniami do samodzielnej nauki
| Site: | SEZAM - System Edukacyjnych Zasobów Akademickich i Multimedialnych |
| Course: | Python, LLM i analiza danych w notatnikach Jupyter |
| Book: | Podręcznik uczestnika z objaśnieniami, przykładami i ćwiczeniami do samodzielnej nauki |
| Printed by: | Gość |
| Date: | Wednesday, 18 November 2026, 10:39 PM |
Table of contents
- 1. Jak korzystać z podręcznika
- 2. Odbiorca, cel i architektura raportu
- 3. Od notebooka eksploracyjnego do finalnego
- 4. Jak opisywać dane, metody i wyniki
- 5. Od obserwacji do wniosków
- 6. Ograniczenia, LLM i wiarygodność
- 7. Finalizacja, prezentacja i ocena projektu
- 8. Podsumowanie i odpowiedzi do samooceny
- 9. Słownik i materiały powiązane
1. Jak korzystać z podręcznika
Moduł 6 zamyka pracę rozpoczętą od przygotowania środowiska i danych. Masz już obliczenia, wykresy oraz doświadczenie w korzystaniu z LLM. Teraz uczysz się zamieniać te elementy w raport, który inna osoba potrafi przeczytać, sprawdzić i ponownie uruchomić. Jego wartość nie wynika z liczby komórek, lecz z przejrzystego związku między pytaniem, dowodem i wnioskiem.
Ten podręcznik rozwija prezentację w materiał do samodzielnego czytania. Objaśnienia, tabele i wykresy są dostępne bez internetu i bez uruchamiania Jupytera. Kod służy zrozumieniu procesu; możesz wrócić do niego podczas pracy z kartą M6. Przykłady przedstawiają syntetyczne dane kursowe, a nie diagnozę rzeczywistej instalacji.
Co będziesz potrafić
Po lekturze zaplanujesz raport dla konkretnego odbiorcy, uporządkujesz notebook i opiszesz metody tak, aby dało się odtworzyć wynik. Nauczysz się ograniczać siłę wniosków do dostępnych dowodów, ujawniać sposób korzystania z LLM i sprawdzać kompletność pakietu projektu.
Każdy rozdział kończy się pytaniem „Sprawdź rozumienie”. Najpierw odpowiedz własnymi słowami, a dopiero później zajrzyj do odpowiedzi na końcu książki. Pytania nie wymagają obliczeń przy komputerze. Pomagają sprawdzić decyzje, które podejmujesz jako autor raportu.
2. Odbiorca, cel i architektura raportu
Raport obliczeniowy łączy narrację z kodem i wynikami. Czytelnik powinien wiedzieć nie tylko, co obliczono, ale także po co, na jakich danych i z jakimi zastrzeżeniami. Notebook eksploracyjny dokumentuje poszukiwanie odpowiedzi. Notebook finalny przedstawia wybraną, sprawdzoną drogę prowadzącą do odpowiedzi. Te role są różne, choć oba pliki mogą korzystać z tych samych danych.
Zacznij od decyzji, nie od formatowania
Przed redakcją ustal odbiorcę, jego potrzebę, cel raportu, pytanie główne, zakres oraz formę przekazania. Odbiorca techniczny może potrzebować szczegółów filtrów i agregacji. Osoba odpowiedzialna za organizację pracy będzie przede wszystkim szukała znaczenia wyników i granic ich zastosowania. Zmienia się kolejność i poziom szczegółowości, ale nie fakty.
W projekcie kursowym możesz przyjąć pytanie: „Jakie najważniejsze różnice i zależności w drganiach, energii i temperaturze ujawniają dane oraz jakie są granice ich interpretacji?”. Jest ono szersze niż pytanie o pojedynczą medianę, ale nadal możliwe do opracowania na podstawie wykonanych analiz. Nie obiecuje prognozowania awarii ani ustalenia przyczyn zużycia.
Zakres należy opisać konkretnie: 720 rekordów pomiarowych, osiem urządzeń, okres od 1 stycznia do 14 lutego 2026 r. i dane przygotowane w module 2. To 45 dni obserwacji, a nie dwa pełne miesiące. Uwzględniasz temperaturę, drgania i energię wraz z dostępnym kontekstem urządzeń. Nie dysponujesz pełną historią serwisową ani eksperymentem pozwalającym oddzielić wpływ wszystkich czynników.
Przykład planu raportu
Odbiorca: osoba analizująca pracę instalacji, która zna ogólny kontekst urządzeń, ale nie śledziła kolejnych notebooków. Cel: wskazać najważniejsze wzorce i obszary wymagające dalszego sprawdzenia. Forma: uporządkowany notebook z wersją do czytania oraz krótką prezentacją. Granica: wyniki opisują zbiór kursowy i nie stanowią samodzielnej podstawy decyzji serwisowych.
Taki plan warto zapisać w sekcji „Plan raportu”. Gdy później zastanawiasz się, czy dodać kolejny wykres, wróć do pytania głównego. Jeżeli element nie pomaga na nie odpowiedzieć ani ocenić wiarygodności odpowiedzi, prawdopodobnie nie należy do części głównej.
Jeden przekaz główny i trzy dowody
Dobre podsumowanie nie jest listą wszystkich funkcji Pandas użytych w projekcie. Powinno prowadzić czytelnika przez niewielką liczbę powiązanych ustaleń. W tym module wybieramy trzy wyniki przewodnie: ranking median drgań, porównanie median energii między halami i okresami oraz zależność temperatury i drgań. Odpowiadają im wykresy M4-W01, M4-W03 i M4-W06 z modułu 4.
Przekaz główny może brzmieć: „W zbiorze występują różnice między urządzeniami i lokalizacjami oraz dodatnia zależność temperatury i drgań; ich interpretacja wymaga uwzględnienia struktury danych i nietypowych pomiarów”. To zdanie łączy trzy obserwacje, lecz nie przedstawia ich jako dowodu awarii czy przewagi technologicznej jednej hali.
|
Element raportu |
Jak wspiera przekaz |
|---|---|
|
Ranking drgań |
Pokazuje kolejność ośmiu median i liczebność każdej grupy; nie tworzy rankingu sprawności urządzeń. |
|
Energia w halach |
Porównuje medianę kWh na interwał dla każdej hali i miesiąca; ujawnia niepełny luty i różny skład grup. |
|
Temperatura i drgania |
Pokazuje kierunek zależności i pojedynczy skrajny punkt; wymaga kontroli korelacji w grupach. |
|
Ograniczenia |
Wyznaczają, do jakich danych odnosi się wynik i jakich wyjaśnień nie można jeszcze potwierdzić. |
Część główna, aneks czy archiwum?
W części głównej zachowaj dane niezbędne do zrozumienia pytania, najważniejsze decyzje metodologiczne, trzy dowody oraz wnioski i ograniczenia. Aneks jest miejscem na pełne tabele kontrolne, rozszerzone obliczenia i dokumentację użycia LLM. Musi być wskazany w tekście i rzeczywiście dostępny w przekazywanym pakiecie.
Nie wszystkie pozostałości eksploracji zasługują na aneks. Kilka prawie identycznych wariantów wykresu, próbne wydruki całej ramki i nieaktualne komentarze można usunąć z kopii redakcyjnej. Oryginalny notebook roboczy zachowaj jako historię pracy. Usuwanie zbędnej prezentacji nie może oznaczać ukrywania niewygodnego wyniku lub decyzji wpływającej na analizę.
Pomocny test brzmi: „Czy bez tego elementu czytelnik nadal rozumie wynik i potrafi ocenić jego wiarygodność?”. Jeśli tak, rozważ przeniesienie szczegółu do aneksu. Jeśli nie, skróć go, ale pozostaw w części głównej.
Architektura i streszczenie
Czytelnik powinien przechodzić od pytania do dowodu, a następnie do znaczenia i granic wyniku. Poniższy układ jest propozycją dla projektu kursowego; nie zastępuje wymagań opisanych w zadaniu w Moodle.
|
Element raportu |
Pytanie, na które odpowiada |
|---|---|
|
Streszczenie |
Co zbadano, co ustalono, co to znaczy i czego nie rozstrzygnięto? |
|
Problem, cel i zakres |
Dla kogo powstał raport i jakie pytanie podejmuje? |
|
Dane i przygotowanie |
Skąd pochodzą dane, co oznacza rekord i jakie decyzje jakościowe podjęto? |
|
Metody |
Jakie filtry, grupowania, miary i porównania prowadzą do wyniku? |
|
Wyniki |
Jakie wartości i wzorce pokazują tabele i wykresy? |
|
Wnioski i ograniczenia |
Co wynika z dowodów, do jakiego zakresu i z jaką ostrożnością? |
|
Dalsze kroki, LLM i aneksy |
Co sprawdzić dalej, jak weryfikowano pomoc modelu i gdzie są szczegóły? |
Streszczenie znajduje się na początku, ale najłatwiej napisać je na końcu. Wcześniejsza wersja może wyznaczać kierunek pracy, jednak po ostatecznych obliczeniach trzeba ją porównać z tabelami. To częste miejsce pozostawienia liczby pochodzącej ze starego wariantu analizy.
Przykładowe streszczenie
Przeanalizowano 720 pomiarów ośmiu urządzeń z okresu 1.01–14.02.2026, aby opisać różnice w drganiach i energii oraz zależność temperatury i drgań. Najwyższą medianę drgań odnotowano dla U-05, Hala A miała najniższą medianę energii w obu dostępnych okresach miesięcznych, a korelacja temperatury i drgań w całej próbie wyniosła 0,644. Wyniki wskazują obszary do dalszej kontroli, ale porównania dotyczą konkretnego składu urządzeń i powtarzanych pomiarów. Na tej podstawie nie można ustalić przyczyn różnic ani zalecić zatrzymania urządzenia.
To streszczenie jest przykładem dydaktycznym dla danych kursowych. Gdy pracujesz na innej wersji zbioru, przelicz wyniki i napisz tekst na nowo. Nie dopasowuj danych do gotowego akapitu.
Sprawdź rozumienie 1
Masz dziesięć wykresów, ale odbiorca potrzebuje odpowiedzi na jedno pytanie. Jak zdecydujesz, które trzy umieścić w części głównej? Dlaczego przeniesienie szczegółu do aneksu nie może oznaczać pominięcia ograniczenia we wnioskach?
3. Od notebooka eksploracyjnego do finalnego
Redakcja notebooka jest pracą nad tokiem rozumowania, a nie tylko nad wyglądem. Zachowaj kopię roboczą i utwórz notebooks/M6_raport_redakcja.ipynb. Dopiero po kontroli zapisz wersję notebooks/M6_raport_finalny.ipynb. Nie nadpisuj jedynego egzemplarza analizy, w którym pozostają uzasadnienia wcześniejszych decyzji.
Najpierw przejrzyj przynajmniej dziesięć komórek. Każdej przypisz funkcję, związek z pytaniem raportu, decyzję redakcyjną i miejsce docelowe. Poniższa mapa pokazuje sposób myślenia, nie obowiązkowy rozkład komórek.
|
Komórka robocza |
Decyzja |
Miejsce i uzasadnienie |
|---|---|---|
|
Importy rozproszone |
Połącz |
Jedna sekcja konfiguracji na początku. |
|
Kolejny odczyt CSV |
Usuń powtórzenie |
Jeden jawny odczyt przygotowanych danych. |
|
Podgląd 720 wierszy |
Skróć |
Paszport danych i niezbędna próbka. |
|
Kontrola klucza |
Zostaw |
Warunek wiarygodności agregacji. |
|
Bilans braków |
Zostaw |
Uzasadnia różne liczebności wyników. |
|
Próba starego filtra |
Usuń z kopii |
Archiwum robocze; sprawdź, czy nic od niej nie zależy. |
|
Ranking median |
Zostaw |
Wynik odpowiadający pytaniu głównemu. |
|
Trzy wersje słupków |
Wybierz jedną |
Wersja czytelna i zgodna z tabelą. |
|
Diagnostyka korelacji |
Skróć i przenieś |
Wniosek w części głównej, szczegóły w aneksie. |
|
Wpis użycia LLM |
Uporządkuj |
Krótka informacja w raporcie i pełny ślad weryfikacji. |
Po zmianie kolejności komórek usuń zależności od ukrytego stanu pamięci. Zmienna powinna powstawać przed pierwszym użyciem, a filtr powinien być widoczny w kodzie prowadzącym do wyniku. Ogólne nazwy typu df1, wynik2 i test nie pomagają odczytać sensu operacji; używaj nazw takich jak pomiary_clean, ranking_drgan i energia_okres.
Refaktoryzacja może zmieniać organizację kodu, ale nie powinna po cichu zmieniać zbioru, miary, sposobu obsługi braków ani kolejności istotnej dla obliczeń. Porównaj wartości przed i po redakcji. Sam fakt, że wykres nadal się pojawia, nie dowodzi zgodności.
Jedno wejście i jawne ścieżki
W przykładach przyjmujemy, że notebook leży w folderze notebooks, a katalog roboczy kernela jest właśnie tym folderem. Path.cwd() pokazuje katalog roboczy procesu, nie automatycznie położenie pliku notebooka. Jeśli uruchamiasz Jupytera inaczej, sprawdź tę wartość i świadomie ustaw katalog główny projektu.
from pathlib import Path
import hashlib
import pandas as pd
import matplotlib.pyplot as plt

NOTEBOOK_DIR = Path.cwd()
PROJECT_DIR = NOTEBOOK_DIR.parent
PLIK_DANYCH = PROJECT_DIR / "data/processed/pomiary_clean.csv"
TABLES = PROJECT_DIR / "outputs/tables"
FIGURES = PROJECT_DIR / "outputs/figures"
assert PLIK_DANYCH.is_file(), "Sprawdź katalog roboczy i ścieżkę"
TABLES.mkdir(parents=True, exist_ok=True)
FIGURES.mkdir(parents=True, exist_ok=True)

pomiary_clean = pd.read_csv(
    PLIK_DANYCH, parse_dates=["czas", "data_instalacji"]
)
suma_sha256 = hashlib.sha256(PLIK_DANYCH.read_bytes()).hexdigest()
print("Źródło:", PLIK_DANYCH)
print("SHA-256:", suma_sha256)
W całym projekcie stosujemy outputs, a nie output. Zgodność nazwy folderu w notebooku, README i instrukcji eksportu jest częścią odtwarzalności. Ścieżki względne względem PROJECT_DIR pozwalają przenieść projekt bez przepisywania nazwy dysku czy konta użytkownika.
SHA-256 identyfikuje zawartość pliku na poziomie bajtów. Zapisz rzeczywisty wynik ze swojego uruchomienia wraz z pochodzeniem danych. Nie przepisuj przykładowego skrótu z prezentacji. Zgodny skrót nie dowodzi poprawności danych, a zmiana sposobu zapisu CSV może go zmienić mimo zachowania tych samych wartości.
Ten notebook zaczyna analizę od przygotowanego pliku. Nie dowodzi samodzielnie, że cały proces od danych surowych jest odtwarzalny. Aby wykazać również ten etap, zachowaj notebook M2, źródła i dokumentację jego decyzji oraz sprawdź kolejność wykonania opisaną w README.
Nie uruchamiaj przykładów eksportu w folderze zawierającym jedyną kopię własnych rezultatów. Zapis pod tą samą nazwą zastępuje wcześniejszy plik wynikowy; wersję potrzebną do porównania zarchiwizuj osobno.
Kontrole przed obliczeniami i po redakcji
Przed budowaniem tabel sprawdź oczekiwany kształt danych, kompletność klucza i liczebność grup. Poniższe oczekiwania dotyczą konkretnego zbioru kursowego. Dla nowego zbioru ustala się je na podstawie źródła, a nie po to, żeby dopasować test do uzyskanego wyniku.
KLUCZ = ["czas", "urzadzenie"]
assert pomiary_clean.shape == (720, 14)
assert pomiary_clean[KLUCZ].notna().all().all()
assert not pomiary_clean.duplicated(KLUCZ).any()
assert pomiary_clean["urzadzenie"].nunique() == 8
assert pomiary_clean.groupby("urzadzenie").size().eq(90).all()
assert pomiary_clean["czas"].min() == pd.Timestamp("2026-01-01 08:00")
assert pomiary_clean["czas"].max() == pd.Timestamp("2026-02-14 20:00")
assert pomiary_clean[["temperatura", "drgania"]].notna().all().all()
assert pomiary_clean["energia"].count() == 718
assert pomiary_clean["produkcja"].count() == 719
Nie traktuj niepowodzenia asercji jako przeszkody, którą trzeba szybko usunąć. Zatrzymanie może ujawnić inny plik, nieprawidłowy odczyt lub zmianę danych. Sprawdź przyczynę i udokumentuj decyzję. Mechaniczne zastąpienie oczekiwanej liczby nową liczbą odbiera kontroli sens.
Test czystego uruchomienia
Zapisz notebook, zrestartuj kernel i wykonaj wszystkie komórki od góry. Jeśli wystąpi błąd, popraw pierwszą przyczynę i ponownie zacznij od restartu. Uruchomienie tylko poprawionej komórki nie sprawdza, czy wszystkie zależności są już jawne. Po udanym przebiegu zapisz notebook z aktualnymi wynikami.
Następnie porównaj wyniki po redakcji z zatwierdzoną analizą: wartości median, liczebności, filtry, zakres dat i miary korelacji. Do porównania ramek służy pd.testing.assert_frame_equal; wcześniej ustal wspólny porządek kolumn i wierszy. Nie wystarczy porównać samego shape — dwie różne tabele mogą mieć identyczne wymiary.
Na końcu przeczytaj notebook tak, jak przeczytałaby go osoba, która nie widziała eksperymentów. Czy każdą tabelę poprzedza cel, a po niej następuje objaśnienie? Czy komentarz nadal opisuje aktualny kod? Czy wnioski nie korzystają z liczby, której nigdzie nie wyliczono?
Sprawdź rozumienie 2
Notebook działa po uruchomieniu jednej komórki, ale po restarcie zgłasza brak zmiennej. Co to mówi o jego odtwarzalności? Jak sprawdzisz, że po uporządkowaniu kodu nie zmieniła się treść wyników?
4. Jak opisywać dane, metody i wyniki
Czytelnik nie powinien odgadywać, co oznacza pojedynczy wiersz. W danych kursowych rekord opisuje pomiar danego urządzenia w określonym czasie. Klucz tworzą czas i identyfikator urządzenia. Zbiór zawiera po 90 pomiarów ośmiu urządzeń, wykonywanych dwa razy dziennie przez 45 dni. Liczba 720 opisuje rekordy, nie liczbę niezależnych maszyn.
Paszport danych
Podaj źródło i wersję pliku, jednostkę obserwacji, zakres czasu, liczbę rekordów i urządzeń, znaczenie kluczowych kolumn oraz istotne decyzje jakościowe. W projekcie źródłem analizy jest data/processed/pomiary_clean.csv przygotowany w M2. Szczegóły pochodzenia i przekształceń powinny odsyłać do notebooka przygotowania danych, słownika i tabeli audytu.
|
Zmienna |
Jednostka |
Znaczenie dla raportu |
|---|---|---|
|
temperatura |
°C |
Wartość temperatury w obserwacji; 720 wartości. |
|
drgania |
mm/s |
Wartość drgań; 720 wartości, w tym nietypowy pomiar 4,850. |
|
energia |
kWh na interwał |
Zużycie w interwale opisanym w danych; 718 wartości. |
|
produkcja |
sztuki na interwał |
Wielkość produkcji; 719 wartości po przygotowaniu danych. |
|
lokalizacja i urządzenie |
Kategorie |
Kontekst grupowania, nie dowód przyczyny różnic. |
W raporcie nie musisz przepisywać całego dziennika czyszczenia. Wyjaśnij decyzje wpływające na wynik: dwa braki energii i jeden brak produkcji pozostają jawne, a nietypowych drgań nie usunięto automatycznie. Szczegółów szukaj w sekcji „Dziennik decyzji dotyczących jakości danych” notebooka M2 oraz outputs/tables/M2_audyt_jakosci.csv.
Metoda to więcej niż nazwa funkcji
Zdanie „użyto groupby i median” jest zbyt ubogie. Napisz, jakie rekordy analizowano, po czym je pogrupowano, co mierzono i jak potraktowano braki. Przykład: „Dla każdego urządzenia obliczono medianę drgań ze wszystkich dostępnych obserwacji w badanym okresie. Każda grupa zawierała 90 niepustych wartości; nie wykluczano obserwacji na podstawie wielkości drgań”.
Ranking: jedna tabela jako źródło wartości
Ranking powinien zasilać zarówno wykres, jak i opis. Dzięki temu zmiana danych nie wymaga ręcznego poprawiania kilku niezależnych zestawów liczb. Grupujemy po urządzeniu, liczymy niepuste drgania i sortujemy medianę malejąco. Dodatkowe sortowanie po identyfikatorze zapewnia stabilny porządek przy remisie.
ranking_drgan = (
    pomiary_clean.groupby("urzadzenie", as_index=False)
    .agg(n=("drgania", "count"), mediana_drgan=("drgania", "median"))
    .sort_values(["mediana_drgan", "urzadzenie"], ascending=[False, True])
    .reset_index(drop=True)
)
assert len(ranking_drgan) == 8
assert ranking_drgan["n"].eq(90).all()
assert ranking_drgan["n"].sum() == 720
ranking_drgan.to_csv(TABLES / "M6_ranking_drgan.csv", index=False)
display(ranking_drgan)
Tabela 1. Mediany drgań w całym okresie; zapis do trzech miejsc po przecinku. Plik M6_ranking_drgan.csv jest proponowanym nowym wynikiem M6, a nie wymaganym plikiem wejściowym.
|
Urządzenie |
Mediana drgań [mm/s] |
n |
|---|---|---|
|
U-05 |
1,374 |
90 |
|
U-08 |
1,361 |
90 |
|
U-07 |
1,346 |
90 |
|
U-03 |
1,252 |
90 |
|
U-06 |
1,250 |
90 |
|
U-02 |
1,158 |
90 |
|
U-04 |
1,125 |
90 |
|
U-01 |
1,038 |
90 |
Precyzja zapisu i kontrola wyniku
Obliczenia przechowuj z pełną dostępną precyzją. Na potrzeby tekstu przyjmujemy trzy miejsca i regułę HALF_UP: dokładna mediana U-08 wynosi 1,3605 i jest prezentowana jako 1,361. Ten sam sposób stosuj w tabeli, podpisie, streszczeniu i prezentacji. Różnice licz ze źródłowych wartości, a nie z już zaokrąglonych etykiet.
from decimal import Decimal, ROUND_HALF_UP

def zapis3(wartosc):
    tekst = str(Decimal(str(wartosc)).quantize(
        Decimal("0.001"), rounding=ROUND_HALF_UP
    ))
    return tekst.replace(".", ",")

print(zapis3(ranking_drgan.loc[1, "mediana_drgan"]))
Funkcja zapis3 zwraca tekst do prezentacji, a nie liczbę do dalszych obliczeń. Dla drugiego wiersza rankingu wyświetli 1,361. Nie zmieniamy kolumny mediana_drgan na tekst — dzięki temu można nadal poprawnie liczyć różnice i tworzyć wykresy. Jawna reguła prezentacji ogranicza rozbieżności między tabelą, akapitem a slajdem.
Mediana ogranicza wpływ pojedynczych skrajnych wartości na miarę położenia, ale nie usuwa ich z danych ani nie dowodzi, że są nieistotne. Dlatego ranking median i kontrola nietypowego pomiaru odpowiadają na różne pytania i mogą występować w tym samym raporcie.
Sprawdź zapisany plik, nie tylko ramkę
Po eksporcie możesz ponownie odczytać tabelę i porównać jej wartości z obiektem, z którego powstała. Parametr index=False zapobiega dopisaniu technicznego indeksu jako kolejnej kolumny. Mała tolerancja uwzględnia zapis liczb zmiennoprzecinkowych, ale nie służy ukrywaniu merytorycznych różnic.
ranking_odczyt = pd.read_csv(TABLES / "M6_ranking_drgan.csv")
pd.testing.assert_frame_equal(
    ranking_drgan, ranking_odczyt,
    check_exact=False, rtol=1e-12, atol=1e-12
)
Udana kontrola nie potwierdza, że wybrano najlepszą metodę analizy. Potwierdza węższe twierdzenie: zapis i ponowny odczyt zachowały sprawdzaną tabelę. W audycie zapisuj właśnie taki zakres dowodu. Kontrole techniczne i uzasadnienie metody uzupełniają się, lecz nie zastępują wzajemnie.
Od tabeli do czytelnego akapitu
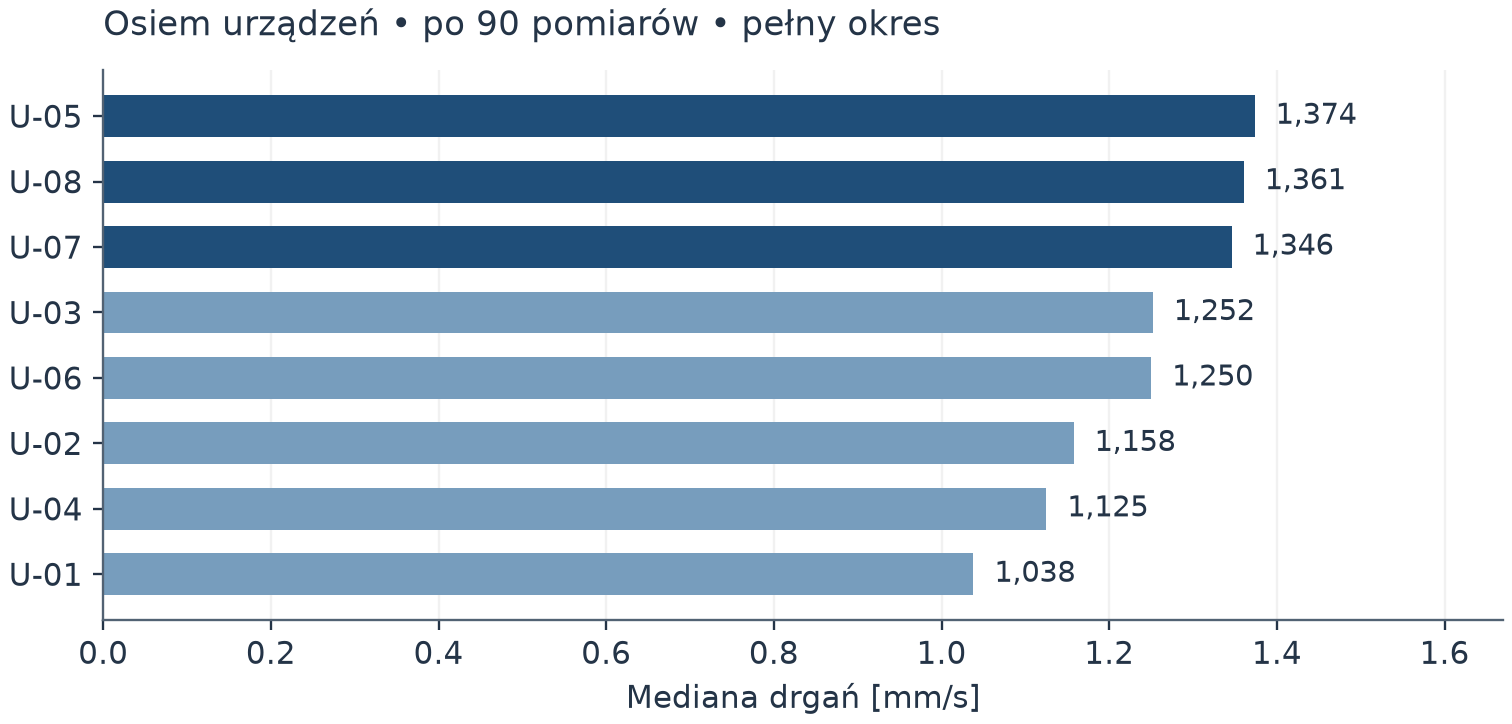
Rysunek 1. Mediany drgań ośmiu urządzeń w okresie 1.01–14.02.2026. Opracowanie na podstawie tej samej agregacji co tabela 1; odpowiednik wyniku M4-W01.
„Najwyższą medianę drgań odnotowano dla U-05: 1,374 mm/s. Kolejne były U-08 i U-07 z medianami odpowiednio 1,361 i 1,346 mm/s. Każdą medianę obliczono z 90 pomiarów. Ranking opisuje poziom drgań w obserwowanym okresie; bez odniesienia do typu urządzenia, warunków pracy i kryteriów diagnostycznych nie jest rankingiem stanu technicznego”.
Ten akapit podaje miarę, jednostkę, zakres, liczebność i ograniczenie. Nie zamienia słowa „najwyższa” na „najgorsza”. Różnica median U-05 i U-08 wynosi 0,013 mm/s, ale sama jej wielkość nie rozstrzyga znaczenia technicznego ani statystycznego. Do takiej oceny potrzebne byłyby dodatkowe kryteria i odpowiednia metoda.
Wykres nie zastępuje tabeli kontrolnej. Służy szybkiemu rozpoznaniu kolejności i skali różnic, dlatego oś zaczyna się od zera, etykiety mają jednostkę, a wszystkie urządzenia pozostają widoczne. Gdy w tekście omawiasz tylko trzy najwyższe wartości, czytelnik nadal może sprawdzić kontekst pozostałych pięciu.
W swoim raporcie nadaj tabelom i rysunkom numery i odwołuj się do nich bezpośrednio. Sformułowanie „jak widać poniżej” staje się niejasne po zmianie układu lub eksporcie. „Tabela 1 przedstawia…” pozostaje czytelne także w wersji offline.
Energia: porównywalna miara, różne grupy
Porównanie energii wymaga wskazania, czy analizujesz sumę, średnią, medianę, czy wartość odniesioną do produkcji. Tutaj porównujemy medianę energii w kWh na interwał. Nie jest to suma zużycia hali ani wskaźnik efektywności energetycznej. Grupę tworzą lokalizacja i miesiąc, a liczebność oznacza niepuste wartości energii.
energia_okres = (
    pomiary_clean.groupby(["lokalizacja", "rok_miesiac"], as_index=False)
    .agg(n=("energia", "count"), mediana_energii=("energia", "median"))
    .sort_values(["lokalizacja", "rok_miesiac"])
    .reset_index(drop=True)
)
assert len(energia_okres) == 6
assert energia_okres["n"].sum() == 718
display(energia_okres)
Tabela 2. Mediany energii i liczby niepustych wartości w grupach. Styczeń obejmuje 31 dni, luty tylko 14 dni.
|
Lokalizacja |
Okres |
Mediana [kWh] |
n |
|---|---|---|---|
|
Hala A |
2026-01 |
13,160 |
186 |
|
Hala A |
2026-02 |
13,080 |
84 |
|
Hala B |
2026-01 |
14,790 |
184 |
|
Hala B |
2026-02 |
14,695 |
84 |
|
Hala C |
2026-01 |
14,645 |
124 |
|
Hala C |
2026-02 |
14,760 |
56 |
Hale A i B obejmują po trzy urządzenia, a Hala C dwa. Dwa brakujące odczyty energii dotyczą Hali B w styczniu. Funkcja size policzyłaby wszystkie rekordy, również te bez energii, dlatego dla pierwszej grupy Hali B otrzymalibyśmy 186 rekordów, lecz tylko 184 wartości użyte do mediany.
W porównaniu sum krótszy okres i różna liczba urządzeń miałyby bezpośrednie znaczenie dla wielkości wyniku. Mediana ogranicza ten problem liczby składników, ale nie zapewnia identycznych warunków porównania. Nadal mieszamy typy i moce urządzeń, tryby pracy oraz poziomy produkcji. Zanim napiszesz, że jedna hala jest „oszczędniejsza”, określ, co dokładnie mierzy takie stwierdzenie.
Wykres energii i granice opisu
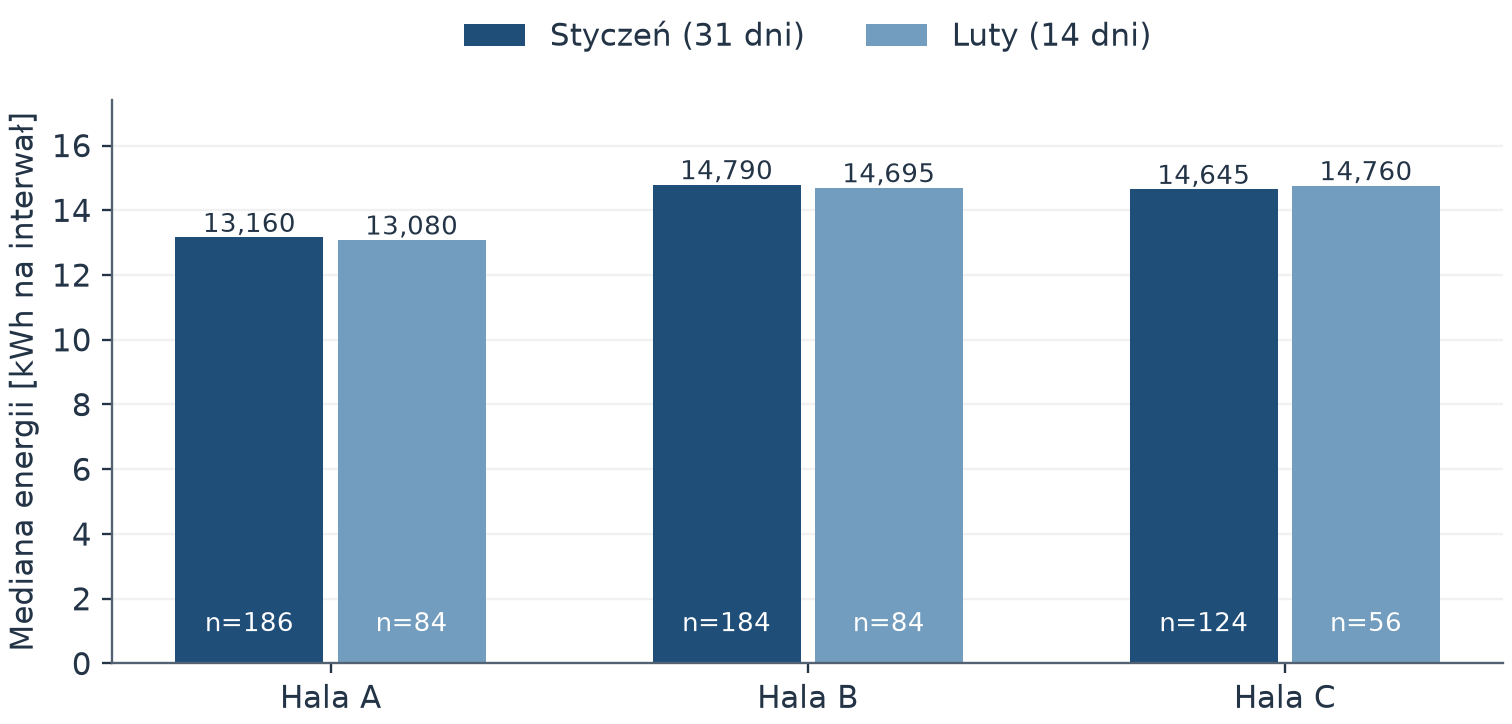
Rysunek 2. Mediana energii według lokalizacji i miesiąca. Na słupkach podano liczby niepustych wartości. Odpowiednik wyniku M4-W03; luty nie jest pełnym miesiącem.
Poprawny opis zaczyna się od widocznego wzorca: „Hala A miała najniższą medianę energii w obu okresach: 13,160 kWh w styczniu i 13,080 kWh w dostępnej części lutego. W Hali B mediana nieznacznie spadła, a w Hali C wzrosła. Porównanie dotyczy pomiarów różnych urządzeń, więc nie izoluje wpływu lokalizacji”.
Nie zastępuj tego opisu zdaniem „Hala A pracuje najefektywniej”. Efektywność wymaga zdefiniowania relacji między nakładem a użytecznym rezultatem, na przykład energii w odniesieniu do produkcji, i sprawdzenia porównywalności procesów. Wykres samych median energii nie dostarcza takiego dowodu.
Jeśli chcesz zbadać zmianę w czasie, zacznij od zgodnego zakresu i jednostki porównania. Możesz rozważyć porównanie tych samych urządzeń w podobnych warunkach pracy oraz sprawdzenie, czy wynik utrzymuje się po uwzględnieniu produkcji. To propozycja dalszej analizy, a nie wynik już wykonany w tym przykładzie.
Przy każdym wyniku oddziel więc trzy elementy: co policzono, co zaobserwowano oraz jakie porównanie byłoby potrzebne do mocniejszej interpretacji. Dzięki temu nawet krótki akapit uczy czytelnika właściwego korzystania z tabeli.
Temperatura i drgania: wynik ogólny
Współczynnik korelacji Pearsona opisuje kierunek i siłę zależności liniowej w analizowanych parach wartości. W zbiorze kursowym temperatura i drgania są kompletne, więc obliczenie obejmuje 720 par. Otrzymujemy dodatnią korelację około 0,644. Nie jest to udział wyjaśnionych przyczyn ani prawdopodobieństwo awarii.
pary = pomiary_clean[["temperatura", "drgania"]].dropna()
r_globalne = pary["temperatura"].corr(pary["drgania"])
print("n =", len(pary), "r =", zapis3(r_globalne))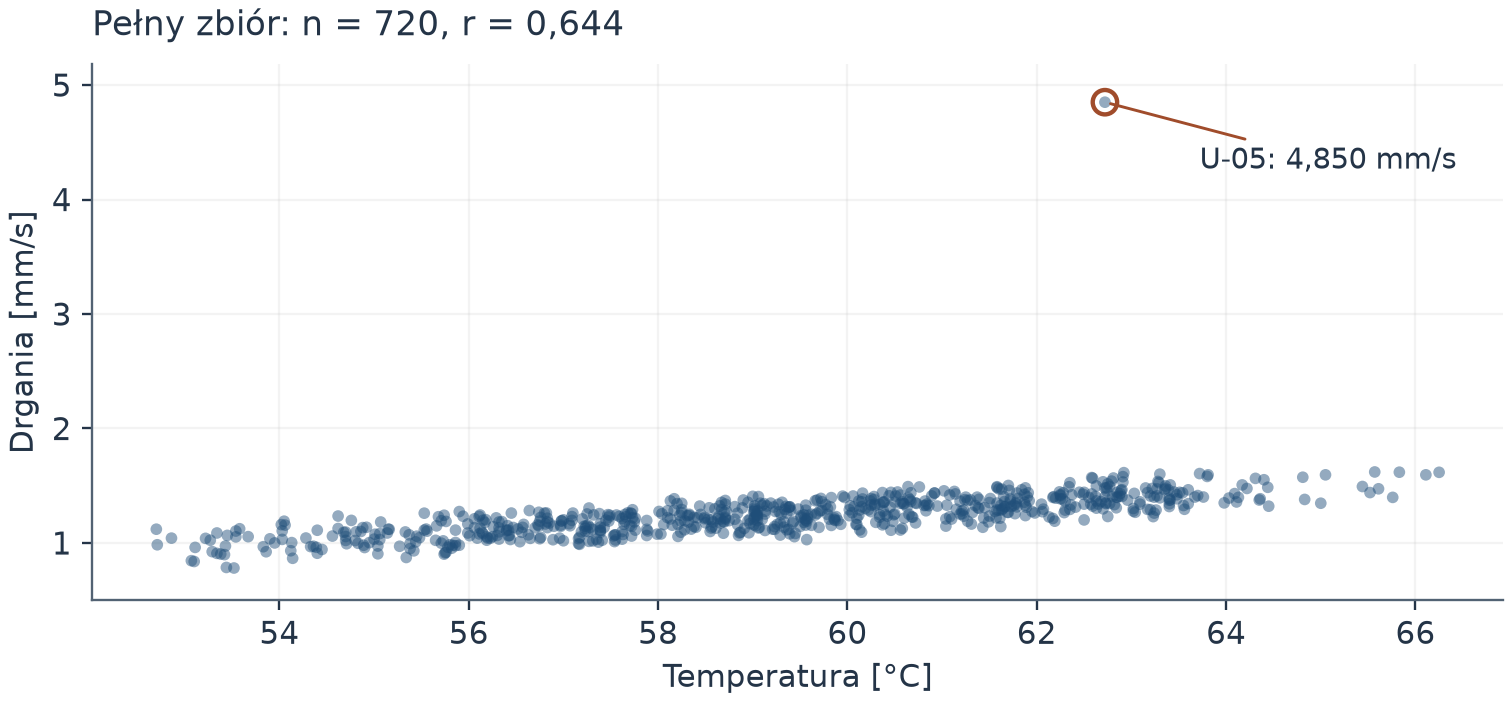
Rysunek 3. Temperatura i drgania w pełnym zbiorze. Zachowano nietypowy punkt 4,850 mm/s; odpowiednik wyniku M4-W06.
Wykres jest potrzebny, ponieważ jedna liczba nie pokazuje kształtu chmury ani wpływu pojedynczych punktów. Obserwacja 4,850 mm/s ma temperaturę 62,72°C i dotyczy U-05. Nie usuwamy jej wyłącznie dlatego, że utrudnia prostą opowieść o związku. Do jej interpretacji wrócimy przy analizie wrażliwości.
Sprawdź rozumienie 3
Tabela energii dla Hali B w styczniu zawiera 186 rekordów, ale n = 184. Czy to sprzeczność? Jakich informacji brakuje w podpisie „Porównanie energii”, aby odbiorca mógł właściwie odczytać wykres?
5. Od obserwacji do wniosków
Największe ryzyko nie zawsze tkwi w obliczeniu. Poprawnie wyliczona liczba może zostać użyta do uzasadnienia twierdzenia, którego analiza nie obejmowała. Dlatego przechodź od danych do rekomendacji małymi krokami i przy każdym sprawdzaj, czy masz wystarczający dowód.
|
Poziom |
Przykład i jego rola |
|---|---|
|
Dane |
Zapisane wartości drgań U-05 w kolejnych terminach pomiaru. |
|
Wynik |
Mediana 1,3735 mm/s z 90 wartości. |
|
Obserwacja |
To najwyższa mediana wśród ośmiu urządzeń w tym zbiorze. |
|
Interpretacja |
Różnica może wiązać się z właściwościami urządzenia lub warunkami pracy; przyczyna nie została ustalona. |
|
Wniosek |
U-05 wyróżnia się medianą drgań, lecz ranking nie określa stanu technicznego. |
|
Dalszy krok |
Sprawdzić pomiary, kontekst pracy i kryteria diagnostyczne przed decyzją operacyjną. |
Wynik jest produktem metody, obserwacja opisuje wzorzec, a interpretacja proponuje jego znaczenie. Wniosek odpowiada na pytanie raportu w granicach dowodów. Rekomendacja wskazuje działanie i dlatego zwykle wymaga dodatkowego uzasadnienia: kosztów, ryzyka, wiedzy dziedzinowej lub zewnętrznych kryteriów.
Dostosuj czasownik do dowodu
„Odnotowano”, „w zbiorze występuje” i „mediana była wyższa” są właściwe dla opisu. „Może być związane z” sygnalizuje hipotezę, którą trzeba sprawdzić. Słowa „powoduje”, „dowodzi awarii” i „należy wyłączyć” wymagają dowodów, których sam ranking czy współczynnik korelacji nie dostarcza.
Ostrożność nie polega na dodawaniu „być może” do każdego zdania. O wartości obliczonej możesz napisać stanowczo: korelacja w tej próbie wynosi 0,644 po zaokrągleniu. Niepewność dotyczy jej znaczenia, uogólnienia i przyczyny. Precyzja wymaga rozdzielenia tych poziomów, a nie rozmycia wszystkich twierdzeń.
Nie przedstawiaj braku dowodu jako dowodu braku problemu. Z danych nie wynika awaria U-05, ale nie wynika z nich również gwarancja sprawności. Jednolity status OK jest polem zbioru; nie zastępuje niezależnej oceny technicznej.
Audyt twierdzeń w praktyce
Wyobraź sobie akapit: „Silna korelacja 0,644 dowodzi, że wzrost temperatury powoduje zużycie urządzeń. U-05 jest w najgorszym stanie, ponieważ ma najwyższe drgania. Należy natychmiast je zatrzymać”. Liczba może być poprawna, ale pozostałe części zdania przekraczają zakres analizy.
Najpierw rozbij tekst na twierdzenia. Korelacja 0,644 jest wynikiem globalnym do sprawdzenia w kodzie. Związek przyczynowy temperatury ze zużyciem nie został zbadany. Ranking stanu technicznego wymaga kryterium diagnostycznego, nie tylko mediany. Natychmiastowe zatrzymanie jest decyzją operacyjną, której raport kursowy nie uzasadnia.
Poprawiona wersja może brzmieć: „W całej próbie zaobserwowano dodatnią zależność liniową temperatury i drgań, r = 0,644 dla 720 par. U-05 ma najwyższą medianę drgań wśród analizowanych urządzeń oraz pojedynczy nietypowy pomiar. Wyniki uzasadniają dalszą weryfikację pomiaru i warunków pracy, lecz nie rozstrzygają przyczyn zależności ani stanu technicznego urządzenia”.
Cztery pytania do każdego ważnego wniosku
- Gdzie jest dowód: konkretna tabela, wykres albo wynik testu?
- Do jakich rekordów, urządzeń i okresu odnosi się twierdzenie?
- Jakie inne wyjaśnienie jest zgodne z tym samym wynikiem?
- Co trzeba dodatkowo sprawdzić, żeby uzasadnić mocniejsze twierdzenie?
Przy porównaniu hal alternatywą dla „wpływu lokalizacji” jest inny skład urządzeń. Przy korelacji temperatury i drgań mogą mieć znaczenie różnice między urządzeniami, ich tryby pracy czy poziom obciążenia. Dostępność zmiennych kontekstowych nie oznacza, że ich wpływ został już wyodrębniony. Opisuj wykonane porównania, a planowane oznaczaj jako dalsze kroki.
W audycie nadaj twierdzeniu werdykt: pozostaw, osłab, usuń lub sprawdź ponownie. Zapisz krótko powód. Usunięcie nieuzasadnionej diagnozy poprawia raport, nawet jeżeli jego zakończenie staje się mniej efektowne. Czytelnik otrzymuje wtedy wiarygodną podstawę dalszej pracy.
Sprawdź rozumienie 4
Czy zdanie „Hala A ma najniższą medianę energii” uzasadnia wniosek „Hala A jest najbardziej efektywna”? Wyjaśnij brakujące ogniwo i zaproponuj jedno sprawdzenie, które przybliżyłoby odpowiedź na pytanie o efektywność.
6. Ograniczenia, LLM i wiarygodność
Ograniczenia powinny wynikać z rzeczywistego zakresu projektu. Zdanie „dane mogą być niedokładne” jest mało użyteczne, jeśli nie wyjaśnia, jak niedokładność mogłaby wpłynąć na wynik. Dobra sekcja nazywa problem, określa jego konsekwencję i wskazuje, co można zrobić dalej.
Zakres i struktura próby
Zbiór kursowy jest syntetyczny i służy nauce. Przedstawia powtarzane pomiary ośmiu urządzeń w krótkim okresie, a nie losową próbę wszystkich instalacji. Hale A i B dostarczają po 270 rekordów, czyli po 37,5% zbioru; Hala C 180 rekordów, czyli 25%. Równoliczność pomiarów urządzeń nie oznacza równej liczby urządzeń w halach.
Ponieważ wielokrotnie mierzono te same urządzenia, nie wolno automatycznie traktować 720 wierszy jako niezależnych obserwacji przy wnioskowaniu statystycznym. Projekt nie przedstawia testu autokorelacji, więc nie stwierdzamy, że ją wykazano. Wskazujemy strukturę danych, którą należałoby uwzględnić w bardziej zaawansowanej analizie.
Braki i nietypowe wartości
Braki są zależne od zmiennej: energia ma 718 wartości, produkcja 719, temperatura i drgania po 720. Usunięcie wszystkich wierszy zawierających jakikolwiek brak zmniejszyłoby cały zbiór do 717 rekordów, mimo że część analiz nie korzysta z brakujących pól. Dlatego liczebność powinna wynikać z danych użytych do konkretnego obliczenia.
Nietypowy pomiar drgań 4,850 mm/s pozostaje w analizie podstawowej. Wcześniejsze przygotowanie danych nie dostarczyło dowodu, że jest błędem. Metoda IQR wskazuje wartości warte uwagi, ale nie stanowi automatycznej reguły kasowania ani diagnostyki urządzenia. Kontekst grupy i reguły dziedzinowe mają znaczenie.
Ograniczenie czy błąd do naprawy?
Niepełna historia serwisowa jest ograniczeniem dostępnych danych. Zły filtr, zdublowane rekordy po połączeniu albo wykres z nieaktualnej ramki są błędami, które należy poprawić i przeliczyć. Nie przenoś ich do sekcji ograniczeń po to, aby pozostawić nieprawidłowy wynik.
Rozróżnienie jest praktyczne: ograniczenie wyznacza granicę uczciwego wniosku, a błąd podważa poprawność wykonania. Jeśli wykryjesz błąd, najpierw napraw łańcuch obliczeń, a dopiero potem redaguj streszczenie i zakończenie.
Analiza wrażliwości korelacji
Analiza wrażliwości sprawdza, jak wynik zmienia się przy jawnie opisanym wariancie obliczenia. Nie służy wybieraniu najładniejszej liczby. W naszym przykładzie porównujemy pełny zbiór z wariantem diagnostycznym bez konkretnego pomiaru U-05 z 8 lutego o 20:00. Usuwamy go tylko z kopii użytej w tym porównaniu, nie z pliku źródłowego.
nietypowy = (
    pomiary_clean["urzadzenie"].eq("U-05")
    & pomiary_clean["czas"].eq(pd.Timestamp("2026-02-08 20:00"))
)
assert nietypowy.sum() == 1
assert pomiary_clean.loc[nietypowy, "drgania"].iloc[0] == 4.85
wariant = pomiary_clean.loc[~nietypowy, ["temperatura", "drgania"]]
r_wariant = wariant["temperatura"].corr(wariant["drgania"])
korelacje_grup = pd.DataFrame([
    {"urzadzenie": nazwa, "n": len(g),
     "r": g["temperatura"].corr(g["drgania"])}
    for nazwa, g in pomiary_clean.groupby("urzadzenie")
])
print("Wariant:", len(wariant), zapis3(r_wariant))
display(korelacje_grup)|
Wariant |
Liczebność |
Korelacja r |
|---|---|---|
|
Wszystkie pary |
720 |
0,644 |
|
Bez wskazanego punktu, diagnostycznie |
719 |
0,817 |
|
Osobno w ośmiu urządzeniach |
Po 90 |
Od 0,102 do 0,778 |
Zmiana z 0,644 na 0,817 pokazuje wrażliwość wyniku globalnego na jeden punkt. Nie dowodzi, że 0,817 jest „prawdziwą” korelacją ani że pomiar należy usunąć. Przyczyna jego nietypowości wymaga osobnej weryfikacji. Wniosek powinien ujawniać oba warianty i zasadę wyboru analizy podstawowej.
Z kolei korelacje w urządzeniach odpowiadają na inne pytanie niż korelacja w połączonych danych. Najniższa występuje dla U-05, najwyższa dla U-07. Wynik globalny miesza zmienność wewnątrz urządzeń z różnicami między nimi; nie jest średnią ośmiu korelacji. Bez dodatkowej analizy nie orzekamy również, że różnice między współczynnikami są statystycznie istotne.
Jak napisać ograniczenia i ujawnić pomoc LLM
Sekcję ograniczeń możesz zbudować z czterech krótkich akapitów. Pierwszy opisuje zakres: osiem urządzeń, 45 dni i syntetyczny charakter danych. Drugi wskazuje jakość: braki zależne od zmiennej i zachowany nietypowy pomiar. Trzeci wyjaśnia metodę: opisowe porównania i korelacje nie oddzielają przyczyn, a pomiary są powtarzane. Czwarty proponuje dalsze sprawdzenia, np. weryfikację nietypowego odczytu oraz porównanie urządzeń w podobnych warunkach pracy.
Umieść ograniczenia obok wniosków i przed opcjonalnymi rekomendacjami. Czytelnik nie powinien poznać zastrzeżeń dopiero po przeczytaniu stanowczego zalecenia. Skróconą informację zachowaj także w streszczeniu i prezentacji.
Ślad pracy z modelem
LLM może pomagać redagować tekst, proponować kod lub wychwytywać niejasności. Autor odpowiada jednak za sprawdzenie obliczeń i twierdzeń. Sama informacja „korzystano z AI” nie pokazuje zakresu pomocy ani sposobu kontroli.
|
Składnik wpisu |
Co udokumentować |
|---|---|
|
Zadanie i cel |
Identyfikator, np. M6-L01, oraz konkretny problem do rozwiązania. |
|
Narzędzie i czas |
Faktycznie użyte narzędzie, model lub dostępne oznaczenie, interfejs i data. |
|
Kontekst |
Jakie dane, wyniki i ograniczenia udostępniono modelowi. |
|
Prompt |
Rzeczywista treść polecenia, nie opis rozmowy z pamięci. |
|
Sugestia modelu |
Kod lub fragment tekstu podlegający ocenie. |
|
Weryfikacja |
Test, porównanie ze źródłem i jego wynik; lokalizacja dowodu. |
|
Werdykt |
Przyjęto, poprawiono lub odrzucono, wraz z uzasadnieniem. |
|
Wpływ na raport |
Co ostatecznie zmieniono i gdzie znajduje się zatwierdzona wersja. |
Pełny wpis może pozostać w sekcji „Udokumentowane wykorzystanie LLM” notebooka M5 lub w aneksie M6. Jeśli odsyłasz do M5, dołącz go do pakietu. Wspólny docs/rejestr_uzycia_LLM.csv zachowuje siedem pól: modul, cel, prompt, odpowiedz_modelu, test_weryfikacyjny, werdykt, uzasadnienie. W uzasadnieniu można wskazać pełny wpis. Nie trzeba tworzyć drugiego równoległego rejestru.
Od sugestii LLM do zatwierdzonego tekstu
Poniższy przypadek jest przykładem dydaktycznym, a nie zapisem rzeczywistej rozmowy. Model otrzymuje tabelę median i proponuje zdanie: „U-05 ma najgorszy stan techniczny i wymaga pilnego serwisu”. Autor porównuje je z zakresem analizy i stwierdza, że tabela opisuje wyłącznie poziom drgań. Odrzuca diagnozę oraz zalecenie, zachowuje informację o najwyższej medianie i dodaje ograniczenie interpretacji.
Dowodem weryfikacji nie jest tu samo „sprawdzono”. Należy wskazać tabelę rankingu, liczbę obserwacji i brak zastosowanego kryterium diagnostycznego. Werdykt brzmi: poprawiono opis, odrzucono nieuzasadniony wniosek i rekomendację. Wpływ na raport jest widoczny w zatwierdzonym akapicie wyników.
Krótka informacja w raporcie
Jeżeli rzeczywiście korzystano z takiej pomocy, skrócona informacja może opisywać trzy kwestie: do czego użyto modelu, jak sprawdzono jego propozycje i kto zatwierdził tekst. Na przykład: „LLM wspierał redakcję opisu wyników. Propozycje porównano z tabelami i zakresem zastosowanych metod; usunięto twierdzenia diagnostyczne bez pokrycia w analizie. Za końcowe obliczenia i interpretację odpowiada autor; szczegóły kontroli zawiera wpis M6-L01 w aneksie”.
Nie wklejaj tego przykładu jako deklaracji wykonanej pracy, jeśli nie odpowiada faktom. Nie dopisuj zmyślonego modelu, daty ani testu. Jeśli identyfikator modelu nie był widoczny, uczciwie odnotuj tę okoliczność. Wpis powinien dokumentować rzeczywistą pomoc, także wtedy, gdy sugestia została całkowicie odrzucona.
Do rejestru nie dopisuj nowego wiersza automatycznie przy każdym wykonaniu Run All. Powtórne obliczenie raportu nie oznacza nowej rozmowy z modelem. Zadbaj o identyfikatory wpisów i świadomie aktualizuj dokumentację. Nowy przypadek z modułu 6 oznacz w kolumnie modul wartością M6.
Modelowi przekazuj tylko potrzebny, dozwolony kontekst. Dane syntetyczne w ćwiczeniu nie zwalniają z zasad obowiązujących przy późniejszej pracy zawodowej. Hasła, tokeny, dane osobowe i informacje poufne nie powinny trafić ani do promptu, ani do pakietu kursowego.
Sprawdź rozumienie 5
Po usunięciu jednego punktu korelacja rośnie z 0,644 do 0,817. Czy należy zastąpić wynik podstawowy większą liczbą? Jak udokumentujesz propozycję LLM, która trafnie opisuje ranking, ale bezpodstawnie zaleca serwis urządzenia?
7. Finalizacja, prezentacja i ocena projektu
Projekt jest gotowy do przekazania wtedy, gdy działa, ma spójne dowody i daje się zrozumieć bez obecności autora. Notebook stanowi główny raport obliczeniowy. Wersja HTML lub PDF ułatwia czytanie, a krótka prezentacja prowadzi odbiorcę przez główny przekaz. Żadna z tych form nie powinna zawierać innej wersji faktów.
Uzgodnione nazwy i role
|
Plik lub folder |
Rola w projekcie |
|---|---|
|
notebooks/M6_raport_redakcja.ipynb |
Kopia do porządkowania; nie zastępuje wersji finalnej. |
|
notebooks/M6_raport_finalny.ipynb |
Zatwierdzony raport z kodem i aktualnymi wynikami. |
|
data/processed/pomiary_clean.csv |
Przygotowane wejście do analizy M6. |
|
outputs/tables oraz outputs/figures |
Tabele i wykresy użyte w raporcie. |
|
outputs/M6_raport_finalny.html |
Wersja do czytania; ewentualny PDF ma ten sam rdzeń nazwy. |
|
outputs/M6_prezentacja_wynikow.pptx |
Proponowana nazwa własnej prezentacji uczestnika. |
|
docs/M6_audyt_projektu.md |
Proponowany zapis testów, dowodów i samooceny. |
|
docs/rejestr_uzycia_LLM.csv |
Wspólny rejestr faktycznego użycia modelu. |
|
README.md |
Mapa projektu i instrukcja odtworzenia. |
W materiałach roboczych możesz spotkać wariant M6_raport_eksploatacja.ipynb. W tym podręczniku i karcie pracy stosujemy M6_raport_finalny.ipynb. Nie utrzymuj dwóch konkurencyjnych nazw w instrukcjach. Analogicznie używaj outputs konsekwentnie w kodzie, dokumentacji i poleceniu eksportu.
M6-v2.pptx to prezentacja dydaktyczna kursu, nie nazwa prezentacji, którą tworzysz jako uczestnik. Nowych nazw wyników nie traktuj jako plików, które powinny już być w pakiecie startowym. Powstają w trakcie pracy. Zachowaj istniejące identyfikatory wykresów M4 w odwołaniach do wcześniejszych analiz, nawet jeśli w raporcie nadajesz im kolejne numery rysunków.
README: instrukcja dla osoby, która zaczyna od zera
README nie jest spisem nazw bez wyjaśnienia. Ma pozwolić nowemu odbiorcy ustalić, co otrzymał i jak odtworzyć wynik. Sprawdź je na świeżej kopii pakietu: jeśli musisz coś dopowiedzieć ustnie, tę informację prawdopodobnie warto dopisać.
|
Część README |
Minimalna użyteczna treść |
|---|---|
|
Cel i pytanie |
Problem raportu, odbiorca i granice zakresu. |
|
Zawartość |
Role notebooków, danych, tabel, wykresów i dokumentacji. |
|
Dane |
Pochodzenie, przygotowanie w M2, wersja i rzeczywisty SHA-256. |
|
Środowisko |
Wersja Pythona, używane biblioteki i sposób przygotowania środowiska. |
|
Uruchomienie |
Kolejność etapów i założenie katalogu roboczego kernela. |
|
Wyniki |
Nazwy rezultatów oraz informacja, że ponowny zapis może je zastąpić. |
|
Użycie LLM |
Lokalizacja rejestru i szczegółowych dowodów weryfikacji. |
|
Ograniczenia |
Najważniejsze granice analizy i zakres wykonanego testu odtwarzalności. |
Opis środowiska powinien przedstawiać wersje faktycznie sprawdzone w projekcie. Nie kopiuj bezrefleksyjnie listy wszystkich pakietów z prywatnego komputera. Zbyt szeroka lista utrudnia odtworzenie, a zbyt krótka pomija zależności. Zapisz co najmniej Python, Pandas i Matplotlib oraz narzędzia potrzebne do uruchamiania i eksportu notebooka.
Dwa zakresy odtwarzania
Odtworzenie M6 od pliku processed oznacza, że z przygotowanych danych uzyskujesz ponownie tabele, wykresy i wyniki raportu. Pełne odtworzenie projektu od raw obejmuje dodatkowo przygotowanie danych w M2, jego kontrole i eksport. W README wyraźnie wskaż, który wariant sprawdzono i jaka jest kolejność notebooków.
Przeniesienie kopii do nowego folderu sprawdza przenośność ścieżek, ale nie niezależność od zainstalowanego środowiska. Osobny test w świeżym środowisku sprawdza deklarowane zależności. Jeśli go nie wykonano, nie deklaruj pełnego potwierdzenia. Dokładny opis zakresu testu jest bardziej wartościowy niż ogólne „działa na każdym komputerze”.
W dzienniku audytu zapisz datę, środowisko, wejściowy plik, wykonane kroki i rezultat. Przy niepowodzeniu wskaż pierwszą przyczynę, poprawkę oraz wynik powtórnego testu. Sam znacznik „gotowe” nie pozwala odróżnić wykonanej kontroli od zamiaru.
Eksport i kontrola wersji do czytania
Najpierw uruchom cały notebook po restarcie i zapisz aktualne wyniki. Następnie z terminala otwartego w katalogu głównym projektu wykonaj poniższe polecenie. Wymaga ono dostępnego narzędzia nbconvert; instalacja środowiska jest opisana w materiałach kursu.
jupyter nbconvert --to html notebooks/M6_raport_finalny.ipynb --output-dir outputsPowstanie outputs/M6_raport_finalny.html. Polecenie bez opcji --execute przekształca zapisany notebook, ale nie uruchamia ponownie komórek. Udany eksport nie jest więc dowodem poprawnego wykonania kodu. Jeśli zapisane wyniki są stare, otrzymasz estetyczny plik ze starymi wynikami.
Otwórz HTML poza Jupyterem. Sprawdź polskie znaki, nagłówki, tabele, kod, etykiety osi i odwołania. Wypróbuj go również bez dostępu do sieci. Obrazy zapisane w wynikach komórek zwykle dają się przenieść z eksportem, lecz zewnętrzne odnośniki, zasoby lub elementy renderowania mogą wymagać połączenia. Samo rozszerzenie HTML nie gwarantuje samowystarczalności.
PDF jest przydatny, gdy potrzebujesz stałego układu stron. Sposób jego przygotowania zależy od dostępnych narzędzi; niezależnie od metody obejrzyj każdą stronę, zwłaszcza szerokie tabele i bloki kodu. Ostateczny format oddania sprawdź w zadaniu w Moodle. Wersja do czytania nie zastępuje notebooka, gdy wymagane jest sprawdzenie obliczeń.
Test przekazania projektu
- Skopiuj komplet pakietu do nowej lokalizacji i postępuj wyłącznie według README.
- Sprawdź dostępność wejść oraz zgodność ścieżek; nie sięgaj do plików poza kopią.
- Uruchom raport po restarcie kernela i ponownie wygeneruj wyniki.
- Porównaj trzy główne ustalenia z tabelami, wykresami i streszczeniem.
- Otwórz eksport i sprawdź, czy zachowuje treść i czytelność bez Jupytera.
Jeśli którykolwiek etap wymaga ręcznego dopisania ścieżki, skopiowania brakującego wykresu lub uruchomienia „zapomnianej” komórki, popraw projekt i instrukcję. Powtórz test od początku. Celem nie jest jednorazowe doprowadzenie pliku do działania, lecz przekazanie procedury możliwej do powtórzenia.
Prezentacja: skrót rozumowania, nie drugi raport
Prezentacja ma ułatwić odbiorcy zapamiętanie głównego ustalenia. Nie powinna powielać wszystkich komórek notebooka. Dla projektu kursowego przydatny jest układ pięciu slajdów, w którym każde ogniwo odpowiada na jedno pytanie.
|
Etap |
Treść slajdu |
|---|---|
|
1. Problem i odbiorca |
Jakie pytanie rozwiązujesz i dlaczego jest ważne? |
|
2. Dane i zakres |
Osiem urządzeń, 720 rekordów, 45 dni; podstawowe ograniczenia. |
|
3. Główny wynik |
Jeden czytelny wykres z miarą, jednostką i liczebnością. |
|
4. Znaczenie i granica |
Co pokazuje wynik, jakie są alternatywne wyjaśnienia i czego nie dowodzi? |
|
5. Wniosek i dalszy krok |
Odpowiedź na pytanie oraz jedna uzasadniona propozycja weryfikacji. |
Wybór jednego wykresu do prezentacji nie oznacza usunięcia pozostałych dowodów z raportu. Możesz odwołać się do nich ustnie lub w krótkim zdaniu, ale slajd nie powinien wymagać równoczesnego odczytywania trzech drobnych wykresów. Najpierw ustal przekaz, potem wybierz ilustrację.
Jeżeli pokazujesz ranking drgań, tytuł „U-05 ma najwyższą medianę drgań w badanym okresie” jest precyzyjniejszy niż „Wyniki”. Dopisz jednak ograniczenie: to nie ranking sprawności. Odbiorca, który zobaczy tylko ten slajd, nie powinien otrzymać innej interpretacji niż czytelnik raportu.
Spójność trzech wersji
Porównaj notebook, eksport i prezentację. Czy wszystkie podają U-05 = 1,374 mm/s, ten sam zakres dat i właściwe n? Czy w jednym miejscu nadal nie pozostała stara etykieta U-08 = 1,360? Czy skracając opis, nie zgubiono informacji o niepełnym lutym albo analizie wrażliwości korelacji?
Zrób próbę opowiedzenia wyniku bez czytania kodu. W dwóch minutach wyjaśnij pytanie, dowód, znaczenie i ograniczenie. Jeżeli musisz długo tłumaczyć, jak interpretować oś, popraw wykres. Jeżeli zakończenie nie odpowiada pytaniu ze slajdu pierwszego, wróć do planu raportu.
Nie deklaruj w prezentacji wykonania dodatkowych analiz tylko dlatego, że brzmią profesjonalnie. Propozycja dalszej kontroli jest wartościowa również wtedy, gdy jasno zaznaczysz, że pozostaje do wykonania.
Samoocena oparta na dowodach
Przed oddaniem projektu oceń nie tylko wygląd, ale cały łańcuch pracy. Kryteria poniżej odpowiadają obszarom omawianym w module; nie wprowadzają nowych wag ani progów ocen. Wiążące wymagania i zasady zaliczenia znajdują się w zadaniu kursowym.
|
Kryterium |
Przykład dowodu do wskazania |
|---|---|
|
Problem i pytania |
Plan raportu i zgodna z nim odpowiedź we wnioskach. |
|
Przygotowanie danych |
Notebook M2, audyt jakości i udokumentowane decyzje. |
|
Analiza w Pandas |
Jawne filtry, grupowania, miary i kontrole liczebności. |
|
Wizualizacja |
Wykresy z jednostkami, czytelnymi etykietami i zgodnymi tabelami. |
|
Interpretacja |
Wnioski powiązane z dowodami, bez nieuzasadnionej przyczynowości. |
|
Odtwarzalność |
Zapis udanego testu od wskazanego wejścia i opis środowiska. |
|
Kod i dokumentacja |
Czytelna kolejność komórek, zgodne nazwy oraz kompletne README. |
|
Użycie LLM |
Rzeczywisty rejestr, testy, werdykty i jawna odpowiedzialność autora. |
Przy każdym kryterium zanotuj lokalizację dowodu, status i ewentualną poprawkę. Statusy „potwierdzone”, „do poprawy” i „brak dowodu” są bardziej użyteczne niż ogólna ocena, że projekt wygląda dobrze. Jeśli nie korzystano z LLM w danym etapie, odnotuj to zgodnie z prawdą; nie twórz fikcyjnego wpisu dla zapełnienia rubryki.
Końcowy audyt trzech wniosków
Wybierz trzy najważniejsze zdania podsumowania. Dla każdego przejdź wstecz: wniosek, akapit wyników, tabela lub wykres, agregacja, filtr i źródło. Sprawdź jednostkę, n, zaokrąglenie i ograniczenie. Następnie upewnij się, że kod odtwarza tę samą liczbę po restarcie kernela.
Popraw przynajmniej jeden rzeczywiście wykryty problem i zapisz, jak sprawdzono poprawkę. Jeśli audyt niczego nie ujawnił, nie wymyślaj błędu; wykonaj dodatkową kontrolę i odnotuj jej wynik. Profesjonalna dokumentacja rozróżnia wykonaną pracę, zamiar i brak dowodu.
Sprawdź rozumienie 6
Notebook poprawnie wyeksportowano do HTML, ale nie uruchomiono po restarcie kernela. Co zostało potwierdzone, a czego nadal nie wiadomo? Dlaczego test w innym folderze nie jest tym samym co test w nowym środowisku?
8. Podsumowanie i odpowiedzi do samooceny
W module 6 łączysz wcześniejsze umiejętności w jeden rezultat: raport, którego treść daje się zrozumieć, a wynik sprawdzić. O jakości decyduje zgodność pytania, danych, metody, wizualizacji i wniosków. Wersja offline ma zachować ten łańcuch także wtedy, gdy czytelnik nie uruchamia kodu.
Odpowiedzi do pytań
1. Wybierz dowody najlepiej odpowiadające na pytanie główne, uzupełniające się i możliwe do rzetelnego wyjaśnienia. Liczba wykresów nie jest celem. Szczegóły analizy mogą trafić do aneksu, ale ograniczenie zmieniające sens wniosku musi pozostać widoczne przy tym wniosku.
2. Brak zmiennej po restarcie wskazuje zależność od stanu pamięci lub nieprawidłową kolejność komórek. Zmienna musi powstać w jawnym łańcuchu wykonania. Po redakcji porównaj pełne wyniki z zatwierdzonym wariantem, a nie tylko ich wymiary; sprawdź także filtry, miary i liczebności. Potem wykonaj cały notebook od początku.
3. To nie sprzeczność: 186 oznacza liczbę rekordów, a 184 liczbę niepustych wartości energii. Dwa rekordy nie uczestniczą w obliczeniu mediany tej zmiennej. Podpis powinien wskazywać miarę, jednostkę, grupowanie, zakres czasu i znaczenie n; w tym przypadku także niepełny luty.
4. Najniższa mediana energii nie dowodzi najwyższej efektywności. Brakuje zdefiniowanego rezultatu użytecznego i porównywalnych warunków. Można zaplanować analizę energii w odniesieniu do produkcji dla porównywalnych urządzeń, uwzględniając braki, wartości zerowe i sens takiego wskaźnika. To dodatkowa analiza, nie wniosek z obecnego wykresu.
5. Większej korelacji nie wybiera się dlatego, że lepiej pasuje do opowieści. Zachowaj wynik podstawowy, ujawnij wariant diagnostyczny i wyjaśnij wrażliwość na punkt. Wpis LLM powinien zawierać propozycję, dowód kontroli, rozdzielenie trafnego opisu od nieuzasadnionego zalecenia oraz zatwierdzoną wersję tekstu.
6. Eksport potwierdza możliwość przekształcenia zapisanej zawartości, nie jej ponownego obliczenia. Test w innym folderze bada m.in. ścieżki i kompletność kopii. Nowe środowisko dodatkowo sprawdza zależności i instrukcję przygotowania. Zakres przeprowadzonej kontroli należy podać wprost.
Ostatnie pytanie przed publikacją
Czy inna osoba potrafi bez Twojej pomocy wskazać źródło trzech głównych wniosków, odczytać ich ograniczenia i odtworzyć wynik według README? Jeżeli tak, raport jest nie tylko uporządkowany — jest użyteczny dla odbiorcy.
9. Słownik i materiały powiązane
|
Pojęcie |
Znaczenie w module 6 |
|---|---|
|
Raport obliczeniowy |
Dokument łączący pytanie, opis, wykonywalny kod i dowody liczbowe. |
|
Notebook eksploracyjny |
Zapis poszukiwań, prób i kontroli; materiał wejściowy do redakcji. |
|
Notebook finalny |
Uporządkowana i zweryfikowana wersja raportu dla odbiorcy. |
|
Jednostka obserwacji |
To, co reprezentuje wiersz; tutaj pomiar urządzenia w danym czasie. |
|
Liczebność n |
Liczba wartości lub par rzeczywiście wykorzystanych w obliczeniu. |
|
Mediana |
Środkowa wartość uporządkowanych danych, a przy parzystym n średnia dwóch środkowych. |
|
Korelacja Pearsona |
Miara liniowej współzmienności; sama nie dowodzi przyczynowości. |
|
Analiza wrażliwości |
Porównanie wyniku przy jawnej zmianie założenia lub wariantu obliczeń. |
|
Ślad dowodowy |
Powiązanie twierdzenia z tabelą, kodem, filtrem i wejściowymi danymi. |
|
Odtwarzalność |
Możliwość uzyskania wyniku ponownie z podanych wejść i procedury. |
|
Ukryty stan |
Obiekty lub zależności niewynikające z wykonania notebooka od początku. |
|
Aneks |
Dostępne uzupełnienie raportu, do którego prowadzi konkretne odwołanie. |
Podstawa i ciągłość materiału
Podręcznik opracowano na podstawie prezentacji M6-v2.pptx i jej notatek prelegenta: rozdział 1 — slajdy 8–27, rozdział 2 — 30–51, rozdział 3 — 54–75, rozdział 4 — 78–99, rozdział 5 — 102–124, rozdział 6 — 127–148; podsumowanie — 151–164. Opisy rozwijają slajdy do samodzielnej lektury, a wyniki tabel i wykresów obliczono dla przygotowanych danych kursowych.
Praktycznym uzupełnieniem jest M6_Instrukcja_raport_koncowy.docx. Do przygotowania danych wracaj przez M2_przygotowanie_danych.ipynb, do eksploracji przez M3_EDA.ipynb, do wykresów przez M4_wizualizacja.ipynb, a do dokumentacji pomocy modelu przez M5_praca_z_LLM.ipynb. Te pliki są materiałami projektu, nie załącznikami osadzonymi w tej książce.
Nazwy i ścieżki odnoszą się do układu pakietu kursowego. Objaśnienia w podręczniku można czytać bez tych plików; do samodzielnego wykonania kodu potrzebne są dane, środowisko i notebook. Wymagania dotyczące oddania projektu oraz jego oceny zawsze sprawdzaj w aktualnym zadaniu w Moodle.